작업 요약에 스스로 지시를 끼워 넣은 모델
컴팩션 요약의 임의 지시가 후속 작업에 미친 영향과 원인 가설, 공개 보고서의 해석 범위를 정리한다.
컴팩션 요약의 임의 지시가 후속 작업에 미친 영향과 원인 가설, 공개 보고서의 해석 범위를 정리한다.

AI 취약점 탐지에 쏠린 자원과 실제 패치 배포의 병목, 윤리적 비용, 코드 이해를 잃는 위험을 Jan Schaumann의 비판을 중심으로 정리한다.
샘 올트먼의 Dreamforce 발언을 바탕으로 AI 통제 상실과 기업 권력 집중을 구분하고, 능력 발전보다 앞서야 할 안전·감시와 사고 보고 문화를 정리한다.

피터 틸과 로스 다우댓의 대담에서 기술 정체, AI의 한계, 정치적 변화와 감시 권력의 위험을 논점과 반론으로 나눠 살펴본다.
AI로 복잡한 시스템을 만들었지만 이해가 따라가지 못한 독자의 질문에서 출발해, 추상화의 경계와 기초 학습, 검증 가능한 LLM 활용을 살펴본다.
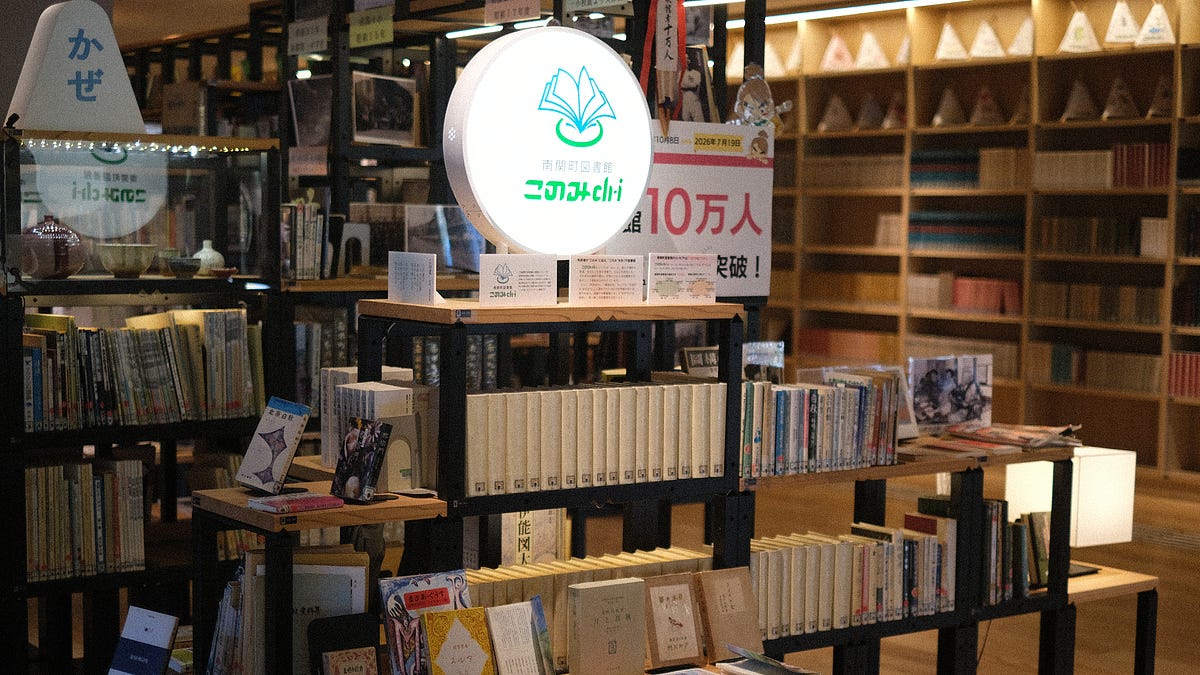
다케오·난칸·야히코의 도서관을 통해 구매 없이 머물 수 있는 공공성, 지역을 소개하는 서가, 주민의 학습을 지탱하는 도서 선정과 운영을 살펴본다.
백업을 설계할 때 복사본, 과거 시점, 보존 주기, 데이터베이스 일관성, 오프사이트 저장과 실제 복구 검증이 차례로 필요한 이유를 정리한다.
TypeSafe 홈페이지와 Jev 출시 글, 개발 문서, 자체 평가를 대조한다. Choice·Score·Noul의 차이, confidence의 의미, 타입 안전성과 판단 정확도의 구분, 속도·비용 비교의 조건을 정리한다.
TypeSafe는 더 높은 지능만을 추구하기보다 기존 소프트웨어가 호출하고 검증하며 조합할 수 있는 AI를 제안한다. 의미 판단과 정확한 계산의 분업, 신뢰할 수 있는 구성 요소, 단계적인 자동화 구상을 정리한다.

All-In Summit 대담에서 젠슨 황이 제시한 AI 안전·공개 모델·산업 확산 전략을 정리한다. 위험 예측에 대한 비판과 실제 사고 통제, 공급망 투자와 네오클라우드의 역할을 구분한다.