역전파 없이 트랜스포머를 사전학습한다, Q Labs의 Dust가 토큰마다 활성값에 잡음을 넣는 이유
Q Labs가 2026년 10월 공개한 Dust의 방법과 결과를 정리한다. 활성값 공간의 영차 최적화로 역전파에 근접하거나 일부 설정에서 앞섰다는 주장과, 소형 모델 실험이라는 범위, 아직 실용적이지 않다는 저자들의 단서를 함께 적는다.
TL;DR
- Dust는 트랜스포머 언어 모델을 역전파 없이 사전학습하는 영차 최적화 방법이다. 저자들은 역전파와 경쟁하는 첫 영차 방법이라고 주장한다. 각 토큰이 가상 모집단의 구성원이 되므로 한 번의 순전파로 수천 개를 평가한다.
- 결과는 작은 설정에서 나온다. 8층, 폭 512의 GPT형 모델을 FineWeb으로 최대 2천만 토큰까지 학습했고, 그 범위에서 집단 크기를 키울수록 역전파에 다가가며, 10만과 100만 토큰에서는 실제로 역전파보다 낮은 손실로 끝난다. 20M 토큰에서 역전파를 넘는다는 값은 외삽한 극한이라 측정값이 아니라고 저자들이 직접 밝힌다.
- 가중치 공간 진화 전략(EGGROLL)보다 10^3~10^4배 효율적이라는 수치도 저자들의 외삽이다. 모델이 클수록 집단 효율이 오르는 경향은 2M~243M 파라미터, 10M 토큰 고정 실험에서 관찰됐다.
- 저자들은 현재 연산 효율로는 역전파를 대체할 수 없고 수 자릿수의 효율 개선이 필요하다고 분명히 적는다. 이 노트는 논문 본문을 읽었으며 부록과 코드는 실행하지 않았다.
무엇을 하려는 방법인가
저자들의 출발점은 Sutton의 「쓰라린 교훈」이다. 연산이 늘면 탐색 같은 일반적 방법이 결국 이기므로, 미분 가능성과 역전파도 저연산 영역에서만 좋은 귀납 편향일 수 있다는 가설이다. 이 가설은 논문의 동기이며 이 논문이 증명한 것은 아니다. 그래서 역전파를 연산에 더 의존하는 탐색형 신용 할당으로 대체해 보는 것이 목표다.
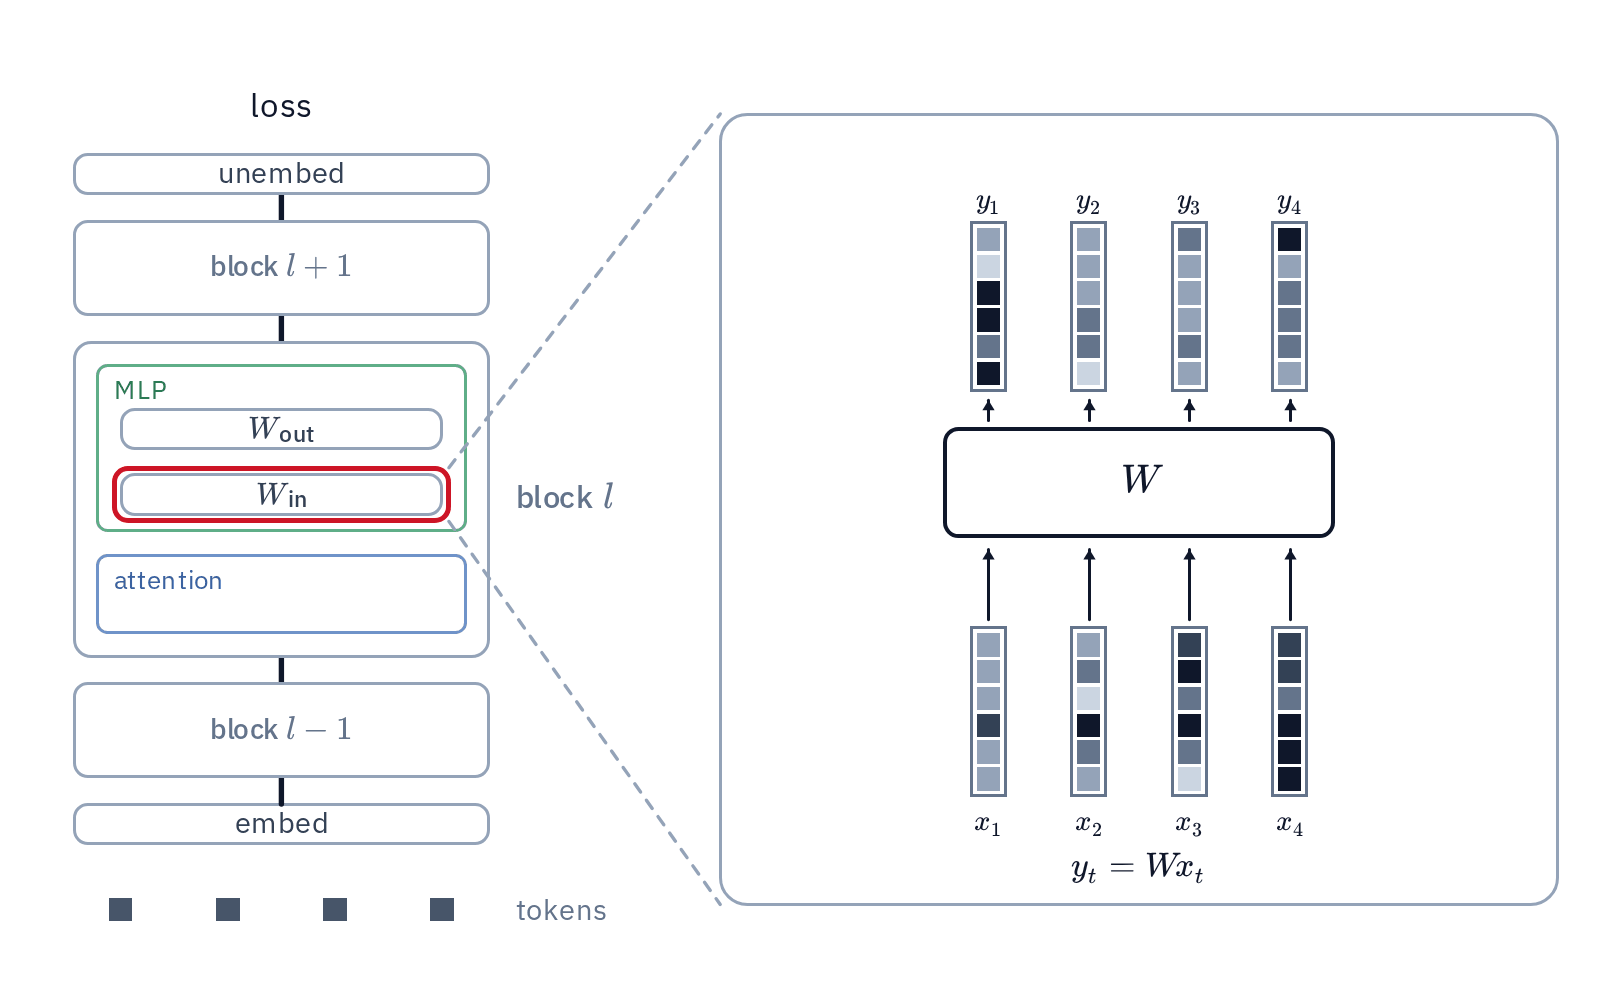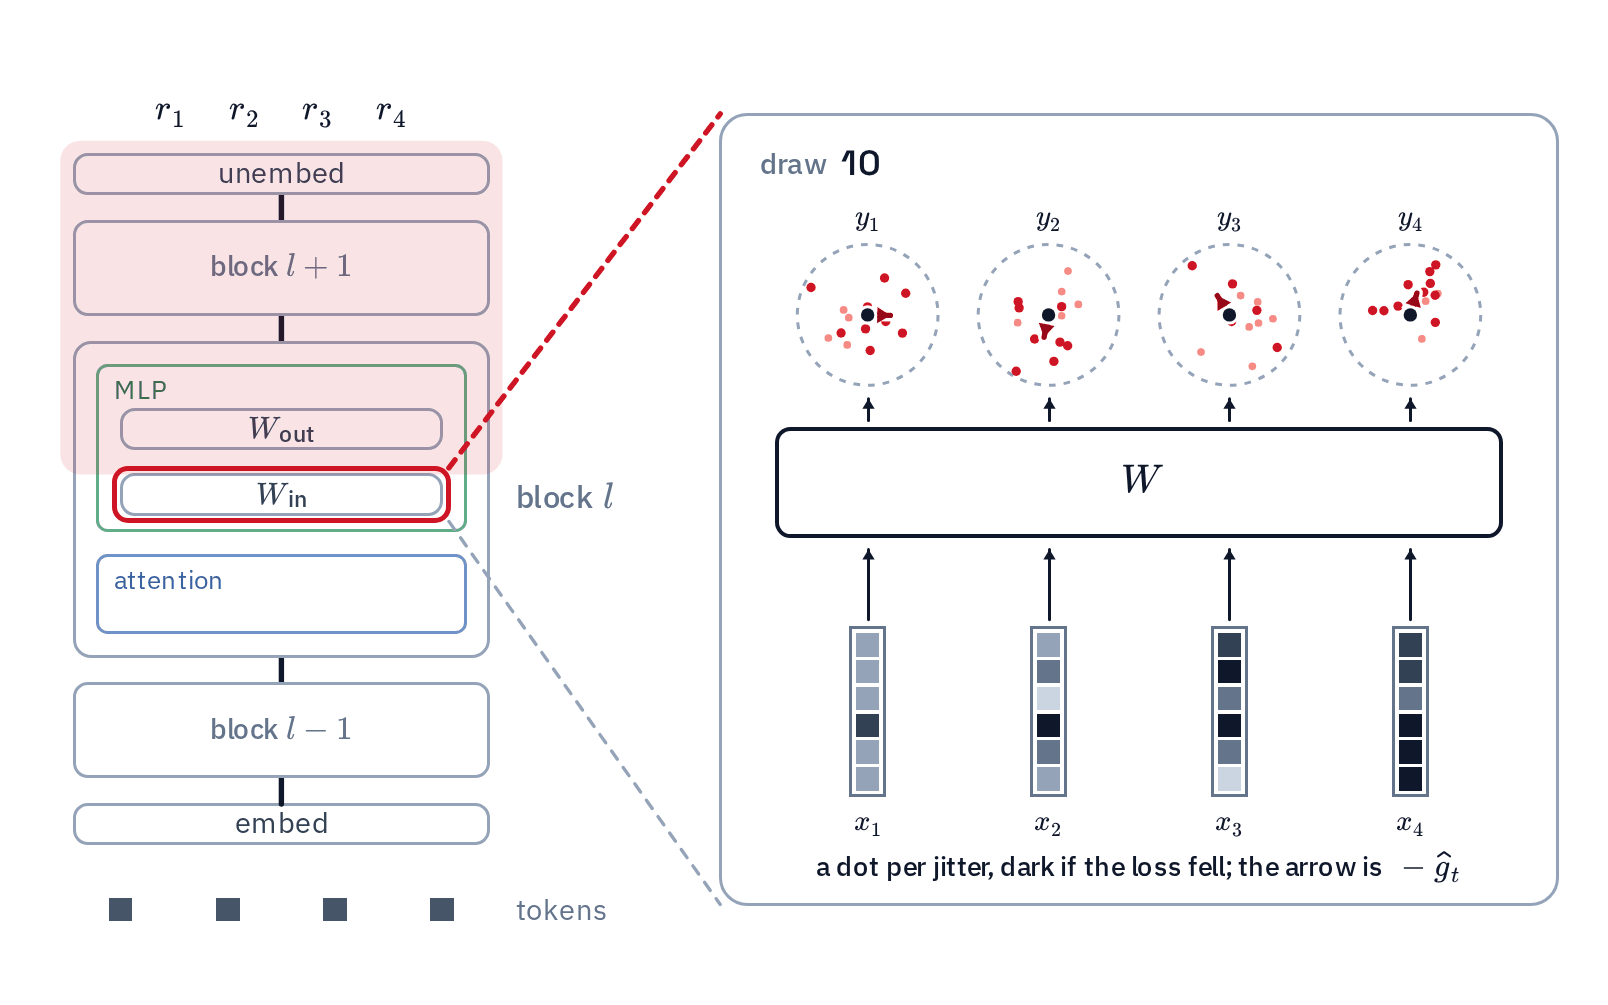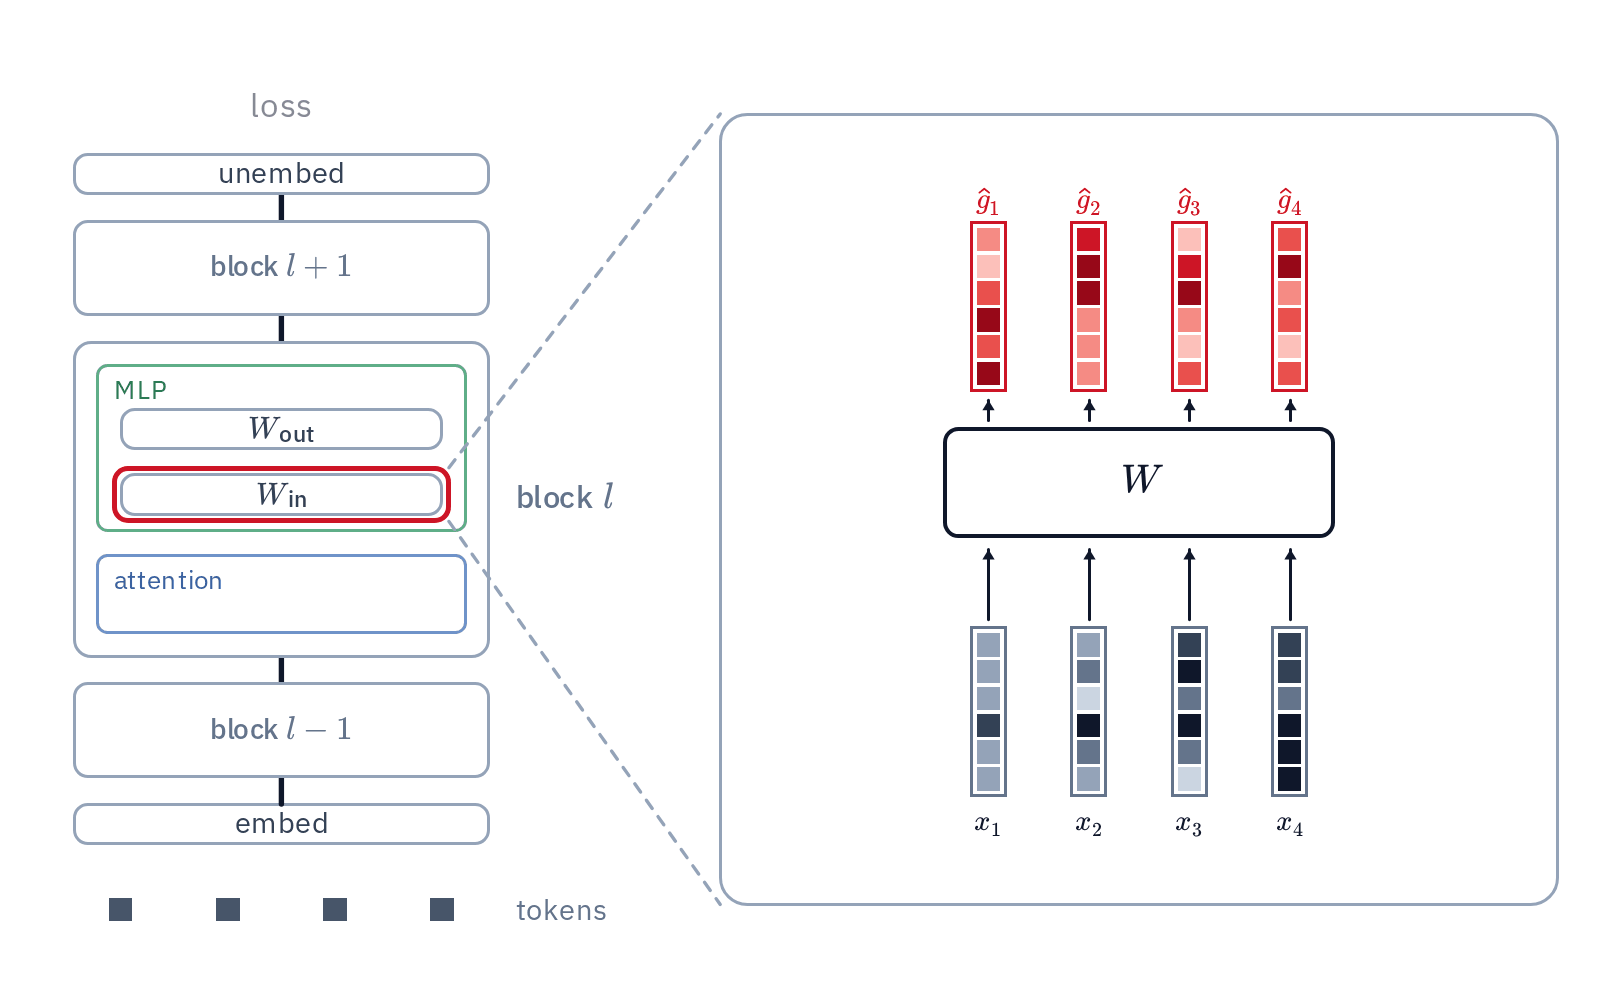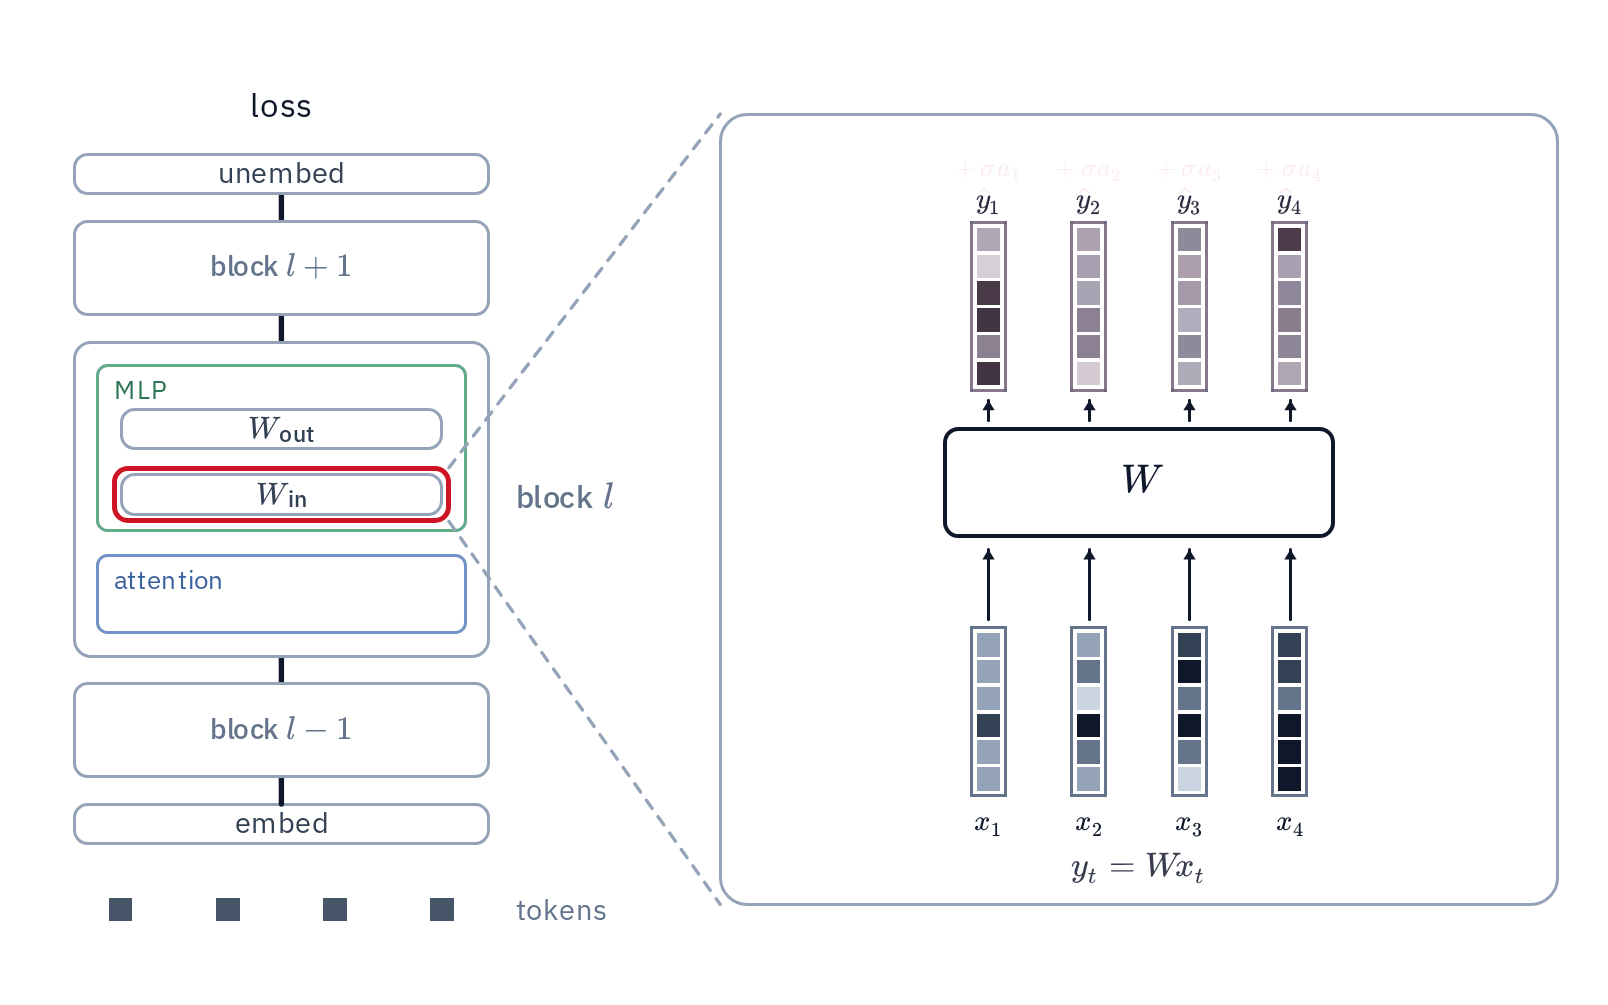
Dust는 각 선형 계층의 출력에 토큰마다 독립적인 가우시안 잡음을 더하고 순전파를 돌린다. 각 토큰의 잡음에는 그 토큰에서의 손실 변화량을 보상으로 준다. 보상으로 가중한 잡음을 여러 번(한 번의 전체 토큰 섭동을 draw라 부른다) 평균하면 그 계층 출력에서의 오차 추정치가 되고 이 추정치와 계층 입력의 외적이 가중치 기울기가 된다. 역전파도 같은 입력으로 같은 외적을 만들며 다른 점은 출력 오차를 연쇄 법칙이 아니라 집단에서 얻는다는 것뿐이라고 논문은 설명한다.
핵심 아이디어는 가상 모집단이다. 가중치를 흔드는 진화 전략은 순전파 한 번에 구성원 하나를 평가한다. Dust는 활성값을 흔들기 때문에 시퀀스의 토큰 수천 개가 각각 하나의 구성원이 되어 같은 순전파에서 함께 평가된다. 저자들은 이로써 가중치 공간 진화 전략보다 적어도 세 자릿수 큰 집단을 평가한다고 주장한다. 어텐션 내부(쿼리, 키, 값 등)는 손실에 직접 잡히지 않아, 어텐션 출력의 추정 오차와 정렬도로 보상하는 변형을 쓰고 뒤 토큰의 손실도 감쇠하며 보상에 반영한다.
실험 설정과 주요 결과
학습 설정은 GPT형 트랜스포머, FineWeb, 4096 토큰 BPE 토크나이저, 배치 1만 6천 토큰, 1 에폭, 모멘텀 SGD다. 기본 모델은 8층에 폭 512이고 모든 방법을 셀마다 시드 3개로 따로 튜닝했으며 비교 기준은 같은 격자에서 튜닝한 역전파와 같은 아키텍처에 구현한 EGGROLL이다. 이 구현은 저자들이 트랜스포머에 맞춘 것이라, 원 논문의 EGGROLL 성능과 같다는 보장은 없다.
토큰 예산 10만에서 2천만, 집단 64에서 1만 6천에 걸친 결과는 다음과 같다. 10만 토큰에서는 수백 draw부터, 100만 토큰에서는 천 draw부터 Dust가 역전파보다 낮은 손실로 끝난다. 1천만과 2천만 토큰에서는 집단이 커질수록 역전파와의 격차가 줄어든다. 2천만 토큰에서는 1만 6천 draw까지도 손실이 계속 떨어지고 있어, 거듭제곱 피팅의 극한은 4.431(95% 구간 3.89~4.58)이며 역전파의 4.633보다 낮다. 그러나 저자들은 적합이 느슨하게 제약되므로 측정된 극한이 아니라 격차가 계속 줄어든다는 증거로 읽으라고 말한다.
EGGROLL과의 격차는 크다. 집단이 256배인 EGGROLL(1만 6천)도 집단 64의 Dust에 못 미친다. 10만 토큰에서는 거의 따라붙지만 100만, 1천만, 2천만 토큰에서는 0.4~0.6 높게 남는다. EGGROLL이 Dust의 최소 집단과 같아지려면 수천에서 약 10^4배 집단이 필요하다는 수치는 사다리를 연장한 추정이다. Adam으로 바꿔도 Dust와 역전파는 함께 개선되고 EGGROLL은 거의 변하지 않았으며 100만 토큰 Adam 설정에서 Dust의 극한 구간(5.17~5.30)이 역전파(5.361) 아래에 있다.
모델이 클수록 유리하다는 관찰
영차 방법은 큰 네트워크에 확장되지 않는다는 것이 통념이다. 순전파가 스칼라 하나만 돌려주므로 흔드는 차원이 늘면 추정 분산이 커진다는 이유다. 저자들은 2M, 7M, 38M, 243M 파라미터(120배 범위) 모델을 10M 토큰에 고정해 이를 시험했다. 집단 256 이상에서는 2M→7M→38M으로 손실이 내려가고 243M은 38M보다 약간 나쁜 정도이며 가장 작은 집단(64)에서도 120배 큰 모델이 작은 모델과 비슷한 손실을 낸다.
큰 모델은 큰 집단도 더 잘 활용한다. 1천 draw를 넘으면 38M과 243M이 2M, 7M보다 약 30% 더 개선된다. 가장 작은 모델은 어떤 집단으로도 경쟁력을 얻지 못한다고 논문은 쓴다. 해석은 저자들의 것이다. 모델 크기를 탐색 공간의 크기와 기하로 보라는 제안이며 과대 매개변수화를 더 넓은 탐색 공간으로 읽는 새 관점이라고 주장한다. 다만 같은 집단에서 역전파와의 격차는 모델이 클수록 조금 벌어진다고 논문이 스스로 적는다. 큰 집단에서는 거의 눈에 띄지 않는 수준이라는 단서가 붙는다.
기울기 정렬 실험도 있다. 역전파로 학습한 10M, 100M, 1B 토큰 체크포인트에서 Dust 추정치와 역전파 기울기의 코사인 유사도를 재면, 집단이 64에서 12만 8천까지 커질수록 모든 계층 유형에서 유사도가 오르고 토큰 규모가 커져도 유지된다. 같은 조건에서 EGGROLL은 출력 머리(head)를 뺀 모든 계층 유형이 12만 8천에서도 코사인 0.05 미만이고, 논문은 이것이 EGGROLL 학습이 진전 없이 끝난 이유일 수 있다고 본다. 저자들은 Dust의 기울기가 역전파와 정확히 같아지지 않는 점을 오히려 장점으로 본다. 다른 최적화 궤적이 가능하고 일부에서는 더 나을 수 있다는 이유다.
저자들이 밝힌 한계와 읽을 때 유의할 점
논문은 자기 범위를 분명히 한다. 현재 연산 수준에서 Dust가 역전파의 실용적 대안이 되려면 연산 효율이 자릿수 단위로 더 좋아져야 한다고 결론에서 말한다. 외부 프로그램이 들어간 네트워크나 여러 단계로 반복되는 트랜스포머처럼 Dust가 열어 주는 새 아키텍처의 학습은 이번에 시도하지 않았다. Dust가 역전파보다 나은 방향을 찾을 수 있는지도 열린 질문이다. 곡률 정보를 잡아 평평한 영역으로 이끄는 것이 아닌가 하는 가설이 있지만, 큰 집단에서 가끔 역전파를 밑도는 단서만 있고 메커니즘은 불분명하다고 논문이 적는다.
내 쪽에서 덧붙일 유의점은 세 가지다. 첫째, 실험은 최대 수천만 토큰, 수억 파라미터 규모라서 수조 토큰으로 사전학습하는 현재의 모델과는 몇 자릿수 떨어져 있다. 둘째, 역전파를 넘어선다는 주장은 작은 토큰 예산(10만, 100만)에서 측정된 값이거나 외삽한 극한이고, 가장 큰 예산(2천만)에서 측정으로 넘은 것은 아니다. 셋째, 이 글은 Q Labs 사이트에 올라온 연구 보고이고 동료 심사를 거쳤는지는 페이지에서 확인되지 않는다. 코드 저장소(github.com/qlabs-eng/dust)가 실제로 열리는 것은 확인했지만 실행하지는 않았다.
그래도 질문 자체는 흥미롭다. 신용 할당을 미분이 아니라 탐색으로 하되 토큰 축이라는 공짜 병렬성을 활용한다는 발상은, 언젠가 연산이 남아돌 때 역전파의 대안이 될 수 있는지를 가늠하는 출발점이다.
참고 자료
Q Labs — Dust: Pretraining Transformers Without Backpropagation — TL;DR, 서론, 방법, 실험(3~4장), 결론과 관련 연구를 읽고 정리했다. 부록과 코드는 읽지 않았다.