LLM에게 문장을 맡기지 않고 편집의 수고를 맡기는 법
글의 표현을 직접 선택하면서 LLM을 문제 탐지와 비교 평가에 활용하는 편집법, 칭찬과 수정본 편향을 줄이는 규칙을 정리한다.
TL;DR
- 원문이 제안하는 역할 분담은 사람이 글을 쓰고 LLM이 결함을 찾는 방식이다. 모델이 제안한 단어와 표현은 채택하지 않는다는 엄격한 규칙을 둔다. 문장을 고르는 판단을 남겨 두면서 반복적인 편집 점검만 덜어내려는 방법이다.
- 칭찬도 글에 영향을 주는 입력이다. 초안을 계속 좋다고 평가하면 작성자가 원래라면 버렸을 구조와 비유에 더 집착할 수 있다. 모델에게 격려를 금지하고 긍정적 평가가 수정 판단을 흐리는지 살펴야 한다.
- 문제를 지적받은 뒤에는 사람이 다시 쓰고 원본과 수정본을 비교한다. 어느 쪽이 새 버전인지 아는 모델은 수정본을 편들 수 있으므로 편집 과정을 모르는 맥락에서 평가받는다. 모델의 판단을 최종 결정으로 받아들이지는 않는다.
대필보다 결함을 찾는 편집자로 쓰기
A Final Ward의 글은 LLM을 글쓰기에서 배제하기보다 역할을 좁혀 쓰는 방법을 제안한다. 먼저 사람이 초안을 작성하고 그다음 좋은 모델에게 결함을 찾게 한다. 모델이 쓴 문장을 나중에 인간답게 손보는 것보다 처음부터 표현의 선택을 자신에게 남기는 접근이다. 글을 더 빨리 다듬되 자기 목소리가 사라지지 않도록 하려는 목적이다.
저자는 모델이 매력적인 표현을 골라내는 능력 자체를 위험 요소로 본다. 각각은 좋은 잡지 제목처럼 들리지만 그런 표현이 문단마다 이어지면 글 전체가 비슷한 맛으로 변할 수 있다. 작성자가 더 좋은 표현이라고 느껴도 그 미세한 변화를 모두 알아차린다고 자신하기 어렵다. 그래서 제안받은 표현 가운데 좋은 것만 고르는 방식보다 모델이 제안한 문구는 사용하지 않는다는 엄격한 경계를 선택한다. 이는 저자가 자신의 문체를 지키기 위해 세운 규칙이며 모든 글쓰기 작업의 보편적 금지 조항은 아니다.
칭찬이 초안을 굳혀 버리는 과정
두 번째 규칙으로 격려를 금지한다. 초안의 구조와 연결, 비유와 단어 선택을 모델이 반복해서 칭찬하면 작성자는 처음 떠올린 아이디어를 더 밀어붙이게 된다. 평소라면 다시 생각하고 문단을 버리거나 교체했을 지점에서 수정이 멈춘다. 저자는 그런 재고와 교체가 개인의 목소리를 이루는 중요한 과정이라고 본다.
한동안 저자는 자신이 글쓴이가 아니라 온라인 매체의 편집자이며 게재할 원고를 심사한다고 모델에게 설명했다. 거리를 두게 하는 효과는 있었지만 이번에는 모델이 가상의 매체 목표에 지나치게 맞추는 문제가 생겼다. 현재는 격려하지 말라고 명시하고 실제 응답에서도 칭찬을 경계하라고 제안한다. 역할 설정 하나가 모델의 비위를 맞추는 성향을 완전히 없애준다는 주장은 아니다.
칭찬을 피한다고 해서 비판을 모두 정답으로 받아들이는 것도 아니다. 원문 말미에서 모델은 글이 20% 정도 길다고 평가했고 저자는 그럴 수 있다고 인정하면서도 고치지 않았다. 이 수치는 적정 길이를 측정한 객관적 결과보다 모델의 편집 의견이다. 무엇을 받아들이고 무엇을 남길지 결정하는 책임을 사람에게 두는 원칙은 칭찬과 비판 양쪽에 적용된다.
반복 점검을 맡기되 문장은 직접 다시 쓴다
모델이 맡기 좋은 일은 지치지 않고 반복해서 결함을 표시하는 작업이다. 수동태를 지나치게 쓰는지, 동사를 명사화해 행동을 감추는지, 같은 표현을 반복하는지 점검할 수 있다. 불필요한 강조 부사나 글의 흐름을 끊는 문단 배치도 검토 대상이다. 다만 같은 항목도 모델의 말을 무조건 따르면 반대 방향으로 과하게 고칠 수 있으므로 지적의 근거를 확인해야 한다.
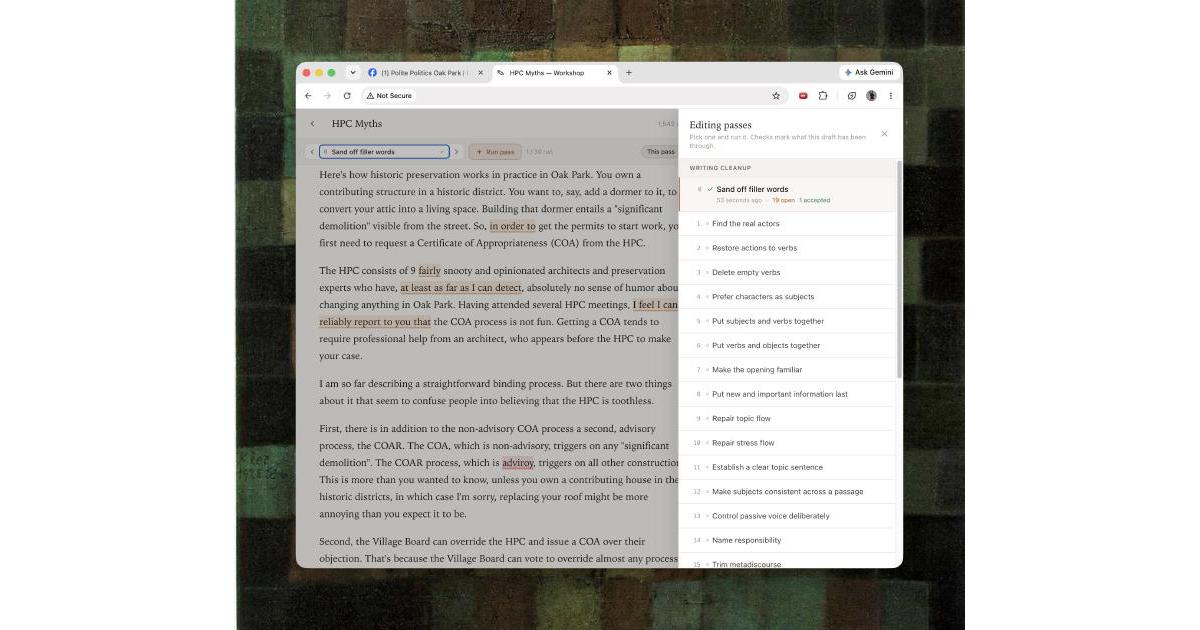
저자는 『Style: Lessons in Clarity and Grace』 같은 책을 읽고 편집 원칙을 메모한 뒤 이를 점검용 프롬프트 목록으로 만들기를 권한다. 한 번에 글 전체를 다시 써 달라고 하는 대신 항목별로 원고를 살펴보는 방식이다. 그러면 모델은 결함이 있는 위치와 이유를 찾고 작성자는 해당 문장이나 문단을 직접 고친다. 반복적이고 피곤한 탐지와 표현을 선택하는 일을 분리하는 구조다.
다시 쓴 뒤에는 원본과 수정본 중 어느 쪽이 나은지 모델에게 물을 수 있다. 그러나 모델이 작성자가 방금 수정했다는 사실을 알면 새 버전을 좋아한다는 대답을 돌려줄 가능성이 있다. 원문은 편집 과정을 모르는 모델 맥락에 두 버전을 전달하라고 제안한다. 이는 수정본을 편드는 단서를 줄이는 장치이며 평가가 완전히 객관적이 된다는 보장은 아니다.
편집 도구도 이 역할 분담에 맞춰 만든다
여러 탭과 편집용 역할 설정을 반복하는 데 지친 저자는 작은 워크숍 도구를 만들었다. 원문에서 제시한 구성은 Python, HTMX, SQLite, 로컬 빌드한 Tailwind이며 문서 편집기와 강조 표시, 해당 구절에 연결되는 사이드바 의견을 포함한다. 제안을 앞뒤로 이동하며 검토하고 문서별 수정 이력과 주요 개정을 표시하는 기능도 요구했다. 핵심은 모델이 완성 원고를 덮어쓰는 흐름보다 사람이 지적과 수정 과정을 관리하는 화면에 있다.
이 도구에 편집 프롬프트 목록을 넣고 Codex·Claude·Antigravity CLI로 각 점검을 실행하도록 구성할 수 있다. 소개된 것은 저자의 작업을 편하게 만든 구현 예시이며 특정 프레임워크 조합이 글의 품질을 보장한다는 뜻은 아니다. 자기에게 필요한 점검과 작업 흐름을 직접 정리하는 과정이 더 중요하다. 모델에게 단어를 고르는 권한을 넘기지 않고 초안에 대한 평가도 그대로 믿지 않으면서 반복 점검의 수고는 충분히 덜어낼 수 있다.
참고 자료
A Final Ward — How To Write With An LLM
이 글은 원문 작성자의 편집 원칙을 정리한 지식 노트이며, 원문 속 도구 제작 프롬프트를 실제 실행하거나 해당 방식을 실험해 효과를 측정한 기록은 아니다.