모델 파일이 작아져도 실험 조건은 남는다 - Qwen 양자화 결과 읽는 법
양자화의 품질과 메모리 절약을 과제 평가 및 재현 조건과 함께 살핀다.
TL;DR
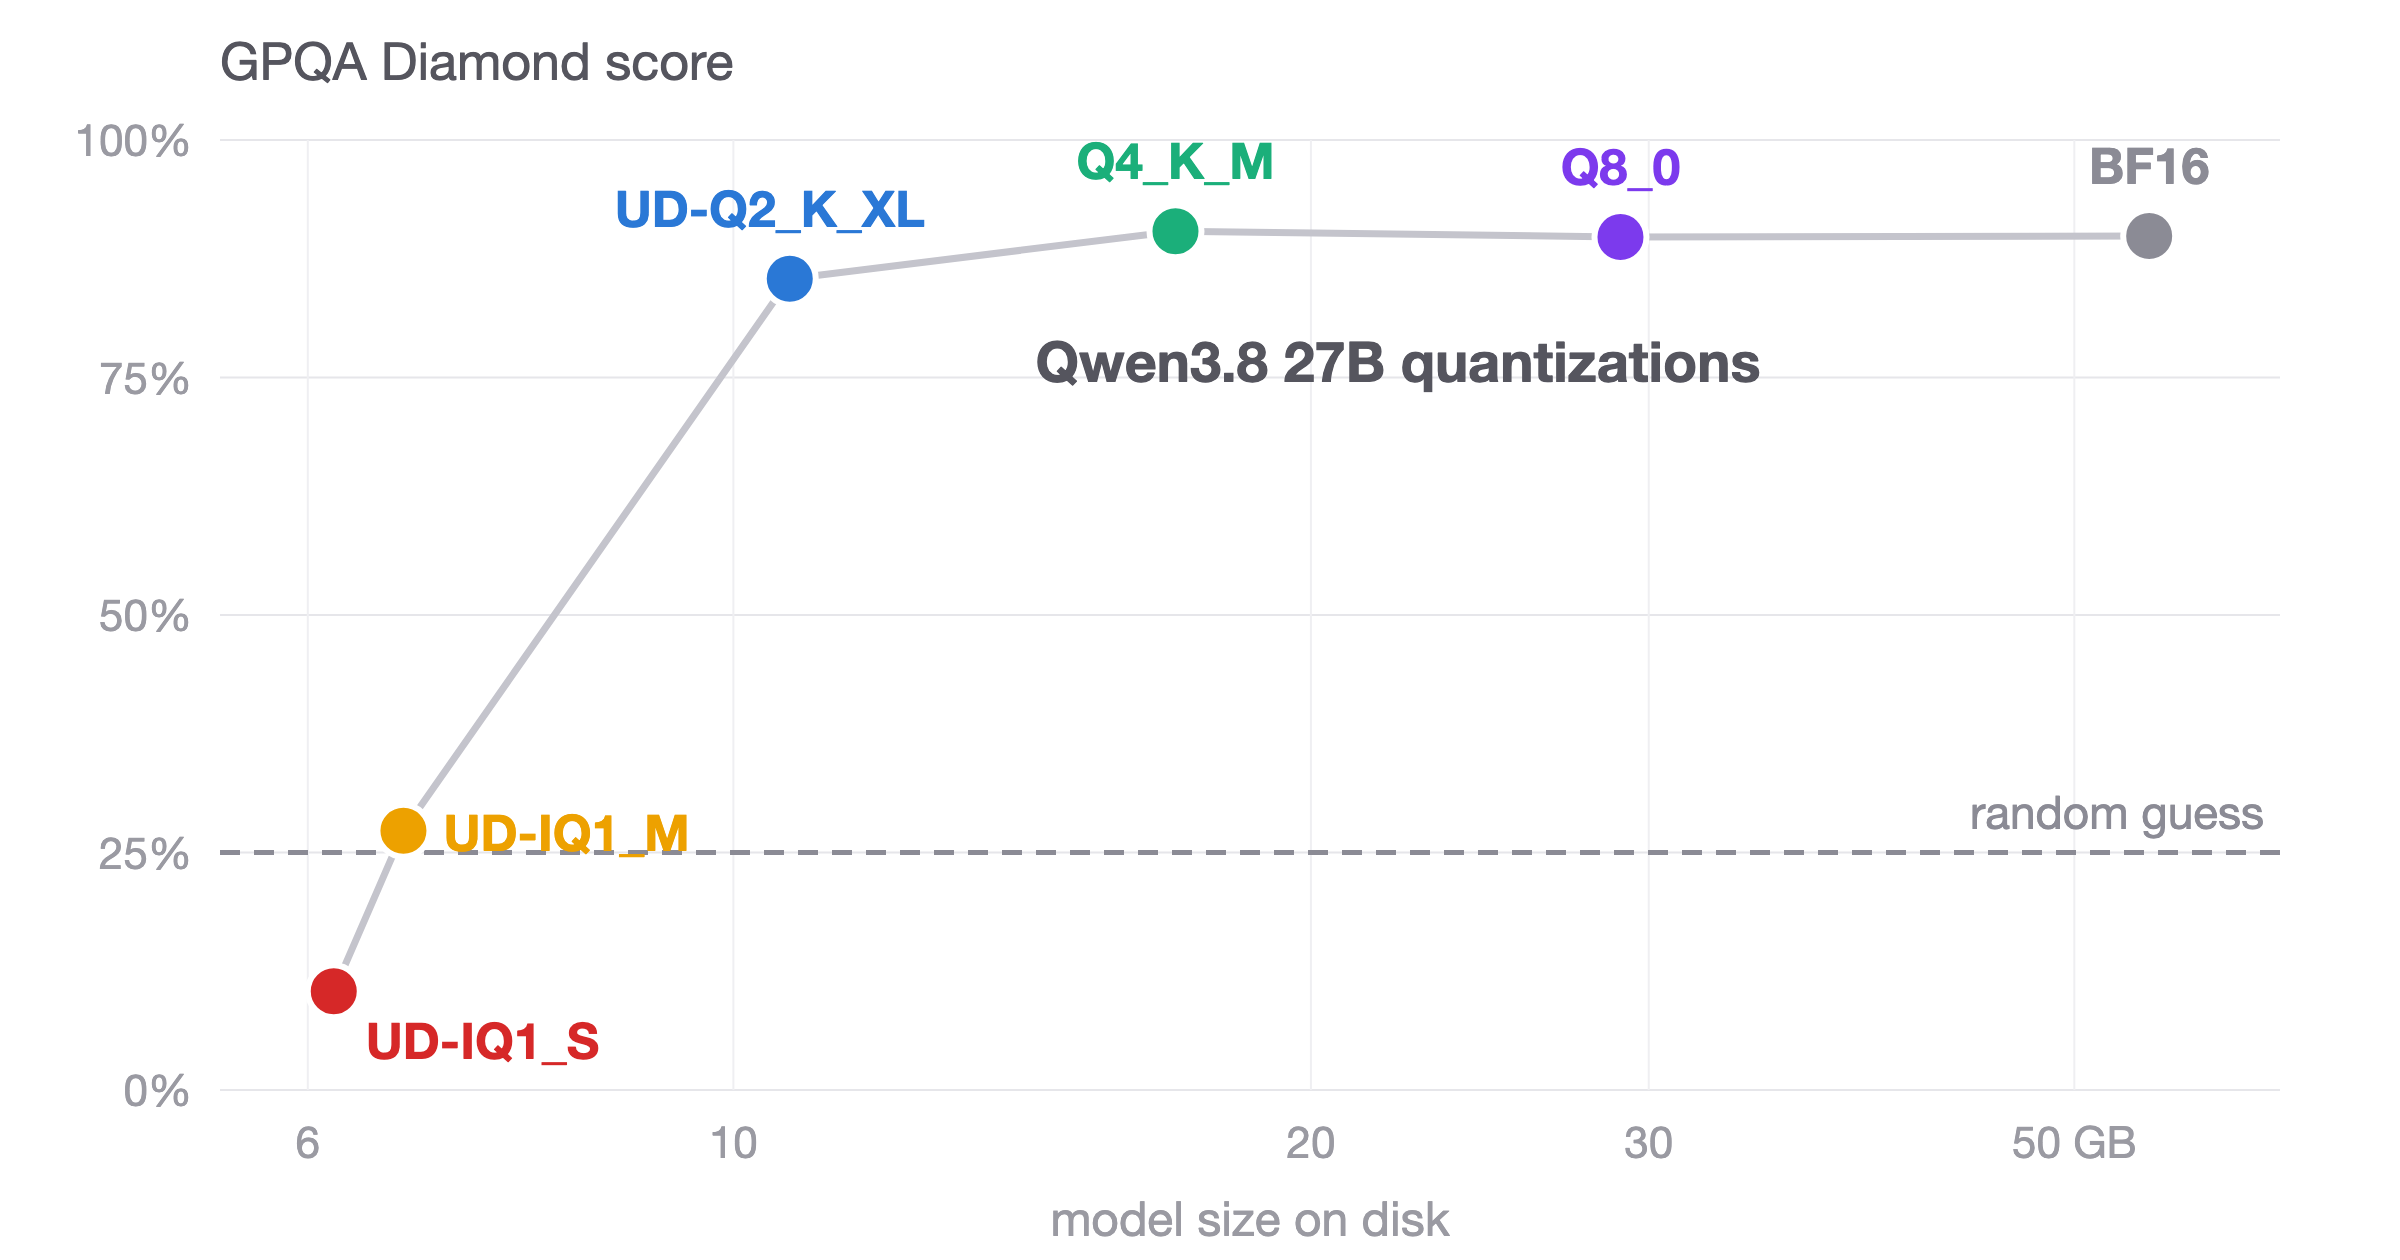
- Qwen3.8 27B의 17GB Q4_K_M은 평가한 과제에서 55GB BF16과 비슷했지만, 1비트에서는 품질이 급격히 무너졌다.
- 가중치와 KV 캐시의 메모리는 별도로 계산해야 한다. 실험은 모든 조건에서 F16 KV 캐시를 사용했다.
- 양자화 파일·실행기·추론 수준·컨텍스트를 함께 남겨야 결과를 비교할 수 있다.
Source
Benchmarking Qwen3.8 27B quantizations: 4-bit holds up, 1-bit collapses
Knowledge
비트 수가 아니라 작업의 성공을 비교한다
Quesma는 과학 문제인 GPQA Diamond, 지시 준수인 IFBench, 코딩 과제인 Terminal-Bench 2.1을 평가했다. 55GB BF16과 17GB Q4_K_M의 결과는 이 평가들에서 비슷했다. 2비트는 지시 준수보다 코딩에서 손실이 컸고 같은 성공 과제에서 출력 토큰이 약 25% 늘었다. 1비트의 과학 문제 성적은 무작위 추측 수준이었다.
토큰 예측이 조금 달라졌다는 사실만으로 작업 실패를 판단할 수는 없다. 표현만 달라질 수도 있고 논리 오류가 생길 수도 있다. 과제 결과를 직접 측정한 이유다. 1비트 조건에서는 추론을 길게 해도 품질이 복구되지 않았고 예산을 소진한 빈 응답도 나타났다.
메모리 절약에도 조건이 붙는다
가중치가 작아져도 대화 문맥을 저장하는 KV 캐시까지 같은 비율로 줄어들지는 않는다. 실험은 F16 캐시를 유지했으며 32k 토큰당 약 2.3GB가 필요했다. 코딩 평가는 xhigh, 3시간 제한, 98k 컨텍스트 조건이었다. 8비트 코딩 평가는 실행하지 않았으므로 그 조건의 직접 측정 결과로 인용할 수 없다.
실행 파일의 동일성도 재현 조건이다. llama.cpp는 2026년 8월 16일 빌드였고 양자화 파일 일부는 이후 교체됐다. 현재 배포본이 당시 파일과 같다고 가정할 수 없다. 파일 해시와 실행기 버전도 비교에 필요하다.
내 GPU에서 검증할 때의 계산 예
다음은 앞의 수치를 이용한 단순 계산이며 추가 벤치마크가 아니다. 24GB GPU에 17GB 가중치를 올리면 명목상 7GB가 남는다. 64k 문맥의 캐시를 약 4.6GB로 계산하면 여유는 약 2.4GB가 된다. 실행기의 작업 공간과 다른 메모리 사용은 아직 빼지 않았으므로 이것만으로 실제 구동을 보장할 수는 없다.
동시 요청이 늘어날 때도 같은 산식을 그대로 재사용해서는 안 된다. 요청마다 필요한 문맥과 캐시 공유 여부가 달라지기 때문이다. 실제 배포 판단에서는 대표 요청을 실행해 최대 메모리와 완료율을 함께 측정하는 편이 정확하다. 단일 요청에서 잘 맞았던 모델이 긴 문맥이나 병렬 처리에서도 적합한지는 별도의 질문이다. 파일을 내려받을 수 있는지와 작업을 안정적으로 완료하는지를 구분해야 한다.
더 생각해보기
- 모델 가중치와 KV 캐시를 합쳐 실제 요청을 처리할 메모리가 남는가?
- 같은 파일과 실행 조건으로 다시 평가할 수 있도록 무엇을 보관할 것인가?