메모리 월을 넘기는 방식이 아키텍처를 갈랐다 - AI 칩 다섯 계보의 설계 철학
GPU·TPU·Cerebras·Groq가 같은 메모리 월을 서로 다른 철학으로 넘는 방식과 칩당 성능 수렴의 의미
메모리 월을 넘기는 방식이 아키텍처를 갈랐다
TL;DR
- 이 글은 개발 중인 AI 칩 계열을 열거한 뒤 실제 배치를 얻은 것만 골라내는데 GPU, 시스톨릭 배열 가속기, 웨이퍼 스케일 엔진, Groq LPU 넷이다. 나머지 뉴로모픽·광학·아날로그는 아직 배치를 얻지 못했다. 판별 기준이 성능 수치가 아니라 실제 배치라는 점이 이 글의 성격을 규정한다.
- 문제 설정이 하나의 벽으로 압축되는데 연산은 지수적으로 늘었지만 메모리 대역폭은 그렇지 않았고 이것이 메모리 월이다. 그래서 칩을 이해하는 일이 네 질문으로 줄어든다. 데이터가 어디 사는가, 연산 유닛까지 어떻게 이동하는가, 연산 유닛은 어떻게 생겼는가, 칩끼리 규모에서 어떻게 대화하는가.
- 각 아키텍처가 같은 벽을 다르게 넘는다. NVIDIA는 프로그래밍 모델을 바꾸지 않고 가속 원시 연산을 얹고, TPU는 컴파일러가 모든 사이클을 미리 계획하며, Cerebras는 웨이퍼를 자르지 않고, Groq는 반응하는 부품을 전부 지운다. 철학이 다르면 포기하는 것도 다르다.
- 비교표가 뜻밖의 수렴을 보여 주는데 칩당 FP8은 B200 4.5, Ironwood 4.6, MI355X 10 페타플롭스로 약 2배 안에 모여 있다. 그래서 결론이 바뀐다. 칩당 경쟁은 근접했고 랙과 포드에서 아키텍처가 갈라진다.
- 가장 인상적인 수치는 균형 지표인데 웨이퍼는 밀집 FP16 플롭당 약 1.3바이트를 먹일 수 있고 B200은 HBM에서 약 0.002를 얻는다. 이 축에서 모든 GPU와 TPU는 굶고 있다는 판정이 나오지만 대가도 같은 행에 보인다. H200 한 장보다 적은 총 메모리와 모든 동세대 GPU에 뒤지는 와트당 밀집 플롭스다.
Source
AI Chip Architectures — jepeake.com
Knowledge
실제 배치를 얻은 것만 센다
이 글은 개발 중인 아키텍처 계열을 먼저 열거한다. GPU, TPU, LPU, NPU, DPU, ASIC, 웨이퍼 스케일 엔진, 재구성 가능 데이터플로, 뉴로모픽, 광학, 아날로그다. 그러나 목록을 나열하는 것으로 끝내지 않고 곧바로 걸러 낸다. 지금까지 실제 배치를 얻은 것은 GPU와 시스톨릭 배열 가속기, Cerebras 웨이퍼 스케일 엔진, Groq LPU 넷이다.
배치 현황이 구체적으로 붙는다. NVIDIA가 명백한 선두이고 AMD가 뒤따르는데, AMD는 OpenAI와 메타 양쪽에서 6기가와트 규모 약정을 받았다. TPU는 제미나이를 훈련하고 최대 100만 개 칩으로 앤스로픽에 서비스할 예정이며 앤스로픽은 100만 개가 넘는 트레이니엄 칩에서도 클로드를 돌린다. Cerebras는 이제 OpenAI 추론을 서비스하고 Groq LPU는 200억 달러 인수 고용으로 NVIDIA에 접혀 들어갔다.
벽은 하나이고 질문은 넷이다
문제 설정이 명료하다. AI 연산은 행렬 곱셈이 지배한다. 트랜스포머는 Q/K/V 투영, 어텐션, 출력 투영, FFN이 이어지는 행렬 곱 연속이고 그 사이에 정규화와 활성화, 잔차 덧셈 같은 원소별 연산이 끼어든다. 프런티어 모델 훈련은 10의 25제곱 회 곱셈 누산을 수행한다.
그런데 그 행렬 곱의 모양이 작업 부하에 따라 달라진다. 훈련과 프리필은 같은 가중치 행렬에 많은 토큰을 쌓으므로 큰 행렬 대 행렬 곱이 되고 산술 강도가 높아 연산 제약이다. 디코드는 다르다. 토큰을 한 번에 하나씩 내보내고 N+1번째는 N번째가 나오기 전에 시작할 수 없다. 단계마다 토큰 하나만 투영되므로 모든 행렬 곱이 행렬 대 벡터 곱이 되고 토큰 하나를 만들려면 모델의 모든 가중치를 한 번 훑고 어텐션을 위해 KV 캐시를 전부 읽어야 한다. 산술 강도가 프리필 대비 몇 자릿수 떨어진다.
추론 시스템은 배치로 그 강도를 일부 되찾는다. 연속 배칭이 여러 사용자의 디코드 단계를 쌓고 추측 디코딩이 요청마다 초안 토큰 K개를 쌓아 한 번에 검증하며 다중 토큰 예측이 같은 기법을 모델 안에 접어 넣는다. 다만 연속 배칭에서 각 사용자 요청은 여전히 자기 KV 캐시를 읽으므로, 긴 문맥 디코드는 가중치 대역폭 제약에서 KV 대역폭 제약으로 옮겨 간다. 그래서 아키텍처 문제가 하나로 정리된다. 행렬 곱이 일어나는 곳으로 숫자를 충분히 빠르게 옮기는 일이고 이것이 메모리 월이다.
NVIDIA는 모델을 바꾸지 않고 얹는다
NVIDIA GPU는 대규모 병렬 프로세서다. 철학은 수천 개 스레드를 가진 프로그래밍 가능한 칩을 호스트 CPU가 조율하고 CUDA로 노출하는 것이 병렬화 가능한 작업 부하에 맞는 기계라는 것이다. 세대마다 프로그래밍 모델을 바꾸지 않고 스트리밍 멀티프로세서에 가속 원시 연산을 더한다. 같은 칩이 트랜스포머를 훈련하고 추론을 서비스하고 그래픽을 렌더링하고 과학 시뮬레이션을 돌린다.
계보가 2006년 테슬라 G80부터 2027년 루빈 울트라까지 이어진다. 2016년 파스칼 P100이 딥러닝을 위해 명시적으로 설계된 첫 GPU였고 2017년 볼타 V100에 첫 텐서 코어가 들어갔다. 이후 A100이 TF32와 구조화 희소성을, H100이 네이티브 FP8과 트랜스포머 엔진을, B200이 FP4와 텐서 메모리를 더했다. SM 개수도 V100 80개에서 A100 108개, H100 132개, B200 148개, B300 160개, 루빈 224개로 늘었다.
여섯 세대에 걸쳐 변하지 않은 것과 변한 것이 대비된다. 행렬 곱은 계속 스레드와 워프 계층 안에 살지만 하나를 발행하는 데 필요한 스레드 수는 줄고 발행 자체가 실행에서 분리됐다. 볼타의 명령은 워프 집합적이고 동기적이어서 32개 스레드가 함께 실행하고 완료까지 막힌다. 호퍼는 발행자를 128개 스레드 워프 그룹으로 넓히고 즉시 반환해서, 행렬 곱이 배경에서 도는 동안 워프 그룹이 다음 타일을 대기열에 넣는다. 블랙웰은 이 이동을 완성해 누산기까지 텐서 메모리에 두므로 레인에 스레드별 상태가 남지 않고 단일 스레드가 명령을 발사한다.
TPU는 컴파일러가 스케줄러다
TPU는 행렬 곱셈 기계다. 철학은 아무 병렬 작업 부하나 돌리는 프로그래밍 가능한 칩 대신 원시 연산 하나에 집중하고 XLA 컴파일러가 모든 사이클과 모든 바이트를 미리 계획하게 하는 것이다. 하드웨어 스케줄러도, 캐시도, 스레드나 워프도 없다. 그래픽을 렌더링하거나 과학 시뮬레이션을 돌릴 야망이 없고 구글의 작업 부하를 어떤 범용 대안보다 와트당 효율적으로 훈련하고 서비스하기 위해 존재한다.
구조가 인상적으로 단순하다. 모든 블록이 코어 시퀀서가 구동하는 단일 VLIW 발행 평면에 앉아 322비트 번들의 여덟 슬롯을 매 사이클 채운다. 명령 캐시 미스도, 워프 스케줄러도, 비순차 엔진도, 분기 예측기도 없다. 컴파일러가 스케줄러이고 절약된 실리콘 면적은 더 많은 곱셈 누산기에 쓴다.
MXU가 시스톨릭 배열이다. 가중치가 셀마다 하나씩 미리 적재되는 가중치 고정 데이터플로이고 활성화가 왼쪽 끝에서 들어와 사이클마다 한 열씩 전파하며 모든 셀에서 상주 가중치와 곱해지고 부분 합이 아래로 흘러 누산 큐로 간다. 배열에 데이터가 들어간 뒤에는 메모리 접근이 일어나지 않는다. 데이터 재사용이 캐시가 중재하는 것이 아니라 실리콘에 배선된다. 근거가 에너지 비용에 있다. 연산의 지배적 비용은 곱셈 자체가 아니라 접근당 100배에서 1000배 더 많은 에너지를 쓰는 메모리 읽기와 쓰기이고 시스톨릭 배열은 그 비용을 구조적으로 삭제한다. 대가는 미충전이다. 256×256 배열에서 128×128 행렬 곱은 실리콘의 75퍼센트를 낭비하므로, XLA가 차원을 128 또는 256의 배수로 타일링하고 패딩하며 모델 코드도 그 양자를 염두에 두고 쓰인다.
메모리 계층도 같은 발상이다. 캐시가 없고 모든 층이 소프트웨어 관리다. 프로그램의 모든 텐서가 컴파일 시점에 한 층에 고정되고 XLA가 소비하는 사이클 직전에 데이터가 도착하도록 DMA를 스케줄한다. 하드웨어는 프리페치도, 축출도, 일관성 유지도 하지 않는다. 컴파일러가 맞히면 배열이 결코 멈추지 않고 틀리면 대안 경로가 없다.
시스톨릭 틀을 깨는 블록도 있다. v4에서 도입된 스파스코어다. 추천과 순위 모델은 임베딩 조회로 사는데 접근 패턴이 밀집 행렬 곱의 정반대로 불규칙하고 간접적이며 전대전이다. 256×256 시스톨릭 배열은 정확히 잘못된 모양이다. 스파스코어는 16개 연산 타일을 가진 데이터플로 프로세서로 텐서코어 옆에 앉아 스캐터와 개더, 분할 축소를 흡수하고 임베딩 중심 모델에서 다이 면적과 전력의 약 5퍼센트로 5배에서 7배 속도 향상을 얻는다.
Cerebras는 톱을 건너뛴다
Cerebras는 지금까지 출하된 가장 큰 칩을 만든다. 철학이 진단에서 나온다. 메모리 월은 웨이퍼를 자른 결과라는 것이다. 팹이 300밀리미터 실리콘에 수십 개 다이를 찍고 톱으로 잘라 내면, 업계는 가장 이색적인 엔지니어링을 동원해 조각들을 온다이 대역폭의 작은 일부로 다시 배선하는 데 쓴다. 랙당 구리 케이블 5,184개가 그 증거다. Cerebras는 톱을 건너뛴다.
웨이퍼 스케일 엔진은 실리콘 한 조각이다. 84개 레티클 필드, 46,225제곱밀리미터, 90만 개 데이터플로 코어이고 온칩 메모리의 모든 바이트가 연산 유닛에서 한 사이클 거리인 SRAM이다. 구조가 GPU와 대비된다. GPU는 워프 안 스레드, SM 안 워프, 패키지 안 다이처럼 경계마다 자기 대역폭과 지연과 프로그래밍 구성물을 가진 계층이다. WSE는 평면이다. 90만 개 동일한 코어가 2차원 메시로 맞닿아 깔리고 공유 캐시도 전역 메모리도 없으며 한 코어와 나머지 89만 9,999개 사이에 어떤 경계도 없다.
수율 문제에 대한 답이 입도다. 1980년대에 웨이퍼 스케일을 무너뜨린 것은 단일 결함이 웨이퍼 컴퓨터 전체를 죽인다는 점이었다. H100에서 결함 하나는 약 6제곱밀리미터 SM 전체를 못 쓰게 하지만 WSE에서 같은 결함은 0.05제곱밀리미터 코어 하나를 못 쓰게 한다. WSE-3은 약 97만 개 코어를 제작해 90만 개를 출하하고 약 7퍼센트 예비 풀과 중복 패브릭 링크로 모든 결함을 우회 사상해 완전한 논리 메시를 복원한다.
플롭스 장부에 주의가 필요하다는 서술이 정직하다. WSE-3의 간판 수치 125 페타플롭스는 희소 FP16이고 하드웨어의 약 8배 영 건너뛰기 이득을 이상적 희소 텐서에 가정한 값이다. 밀집은 대략 15.8 페타플롭스 FP16이다. 그리고 판정이 따른다. 와트당 밀집 플롭스는 모든 동세대 GPU에 진다. 웨이퍼는 애초에 플롭스 기계가 아니었고 대역폭 기계이며 플롭스는 SRAM을 따라가기 위해 존재한다. 정직한 비교가 플롭당 바이트다. 웨이퍼는 밀집 FP16 플롭당 약 1.3바이트를 먹일 수 있고 B200은 HBM에서 약 0.002를 얻는다.
Groq는 반응하는 부품을 전부 지운다
Groq LPU는 결정론적 기계다. 다른 모든 칩은 불확실성을 견디는 데 실리콘을 쓴다. 메모리 지연을 숨기는 캐시, 멈춤을 채우는 스케줄러, 예측할 수 없는 경합을 해소하는 중재기다. LPU는 그것을 전부 삭제한다. 캐시도, 분기 예측기도, 중재기도, 재배열 버퍼도, 온칩 크로스바조차 없다. 스케줄링 문제 전체를 컴파일러에 넘겨 모든 명령과 모든 바이트를 정확한 사이클에 배치한다. 남는 것은 실행하기 전에 지연을 아는 칩이다.
구성 방식도 반대다. 나머지 분야는 복제된 코어로 만든다. SM이나 텐서코어를 다이에 타일링하고 사본들에 작업을 나눈다. LPU는 통상적인 코어 하나를 가져다 뜯어낸다. 명령 제어, 벡터 ALU, 행렬 유닛, 메모리, 네트워크가 각각 기능 슬라이스가 되어 다이 전체 높이의 열이 되고 그 열들이 나란히 선다. 슬라이스를 따라 내려가면 동질적이고 칩을 가로지르면 이질적이다. 데이터는 레지스터 파일에 앉아 발행을 기다리지 않고 조립 라인의 부품처럼 슬라이스를 가로질러 흐르며 VLIW 명령은 제어 슬라이스에서 북쪽으로 발행되어 데이터를 만난다.
희소성 처리가 철학을 드러낸다. MXM은 4개 독립 320×320 곱셈 누산 평면으로 40만 9,600개 곱셈기를 가지고 900메가헤르츠에서 약 750 INT8 TOPS와 188 FP16 테라플롭스다. 그런데 이 수치에는 희소성 각주가 붙지 않는다. TSP는 영을 아예 건너뛰지 않는데, 데이터 의존적 건너뛰기가 실행 시간을 데이터 의존적으로 만들기 때문이다. 결정론은 이 칩이 거래하지 않을 유일한 속성이다.
정의적 제약은 용량이다. 온칩 SRAM 230메가바이트가 계층의 전부이고 HBM도 DRAM도 캐시도 없다. 230메가바이트는 모델을 담지 못한다. Llama-2 70B는 FP16으로 140기가바이트이므로 수백 개 칩에 샤딩해야 하고 배치된 구성은 약 576개 LPU였다. GPU가 소수 패키지의 HBM에 모델을 주차하고 토큰을 지나가게 하는 반면, LPU는 클러스터의 SRAM에 모델을 펼치고 토큰을 클러스터로 통과시킨다. 칩 개수가 연산이 아니라 용량으로 정해진다. Cerebras와 같은 거래를 반대 방향에서 도달한 것이다. Cerebras는 거대한 다이 하나를 유지하고 웨이퍼당 용량을 포기하며 Groq는 정상 크기 다이를 유지하고 모델이 한 칩에 들어가는 것을 영구히 포기한다.
표가 보여 주는 것
비교표의 결론들이 예상을 뒤집는다. 칩당 FP8이 수렴했다. B200 4.5, Ironwood 4.6, MI355X 10 페타플롭스가 약 2배 안에 있다. 칩당 군비 경쟁은 근접했고 랙과 포드가 아키텍처가 갈라지는 곳이다.
HBM 용량은 AMD의 꾸준한 승리다. 2023년부터 2025년까지 192, 256, 288기가바이트로 매 세대 NVIDIA와 같거나 앞섰고 NVIDIA는 2025년 말 B300에서야 288기가바이트로 따라잡았다. 랙 규모 확장은 2026년까지 NVIDIA의 승리다. GB200과 GB300 NVL72가 2024년부터 2025년까지 출하된 유일한 일관 랙 규모 도메인이었고 AMD는 박스 단위로 확장하다 헬리오스에서야 랙 규모에 도달했다. TPU는 질문 자체를 우회한다. 토러스가 랙이면서 동시에 클러스터다.
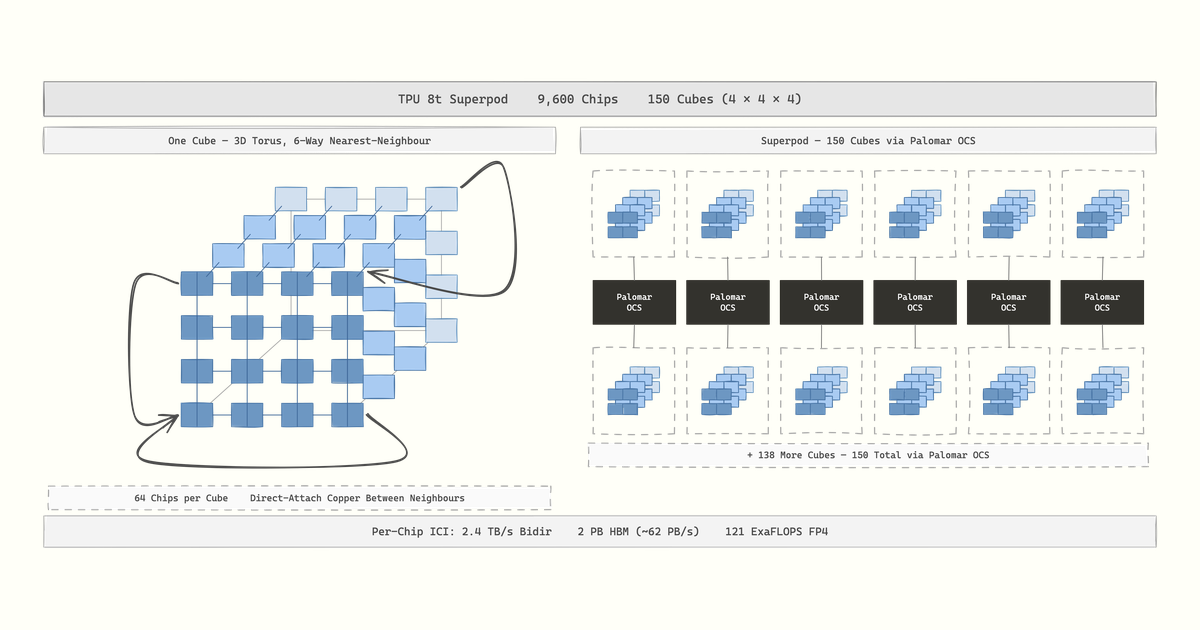
칩 개수에서는 TPU 포드가 어떤 NVIDIA 랙도 압도한다. Ironwood 포드는 9,216개 칩으로 42.5 엑사플롭스 FP8이고 NVL576은 576개 GPU로 약 5 엑사플롭스다. 칩당 균일 요율에 거대한 포드를 곱하는 방식이 시스템당 더 많은 총 연산을 내지만 칩당 대역폭을 대가로 낸다. 칩당 전력은 빠르게 오른다. 700와트 호퍼에서 1,000와트 블랙웰, 1,400와트 B300, 약 1,800와트 루빈 울트라까지다. 1,000와트를 넘으면 액체 냉각이 필수가 되고 공기 냉각은 사실상 호퍼에서 끝난다.
트레이니엄에 대한 평가가 특히 명확하다. 스펙 시트가 아니라 경제성으로 경쟁한다. 칩당으로는 뒤지고 Trn2의 1.3 페타플롭스 FP8은 MI355X의 대략 4분의 1이다. 그런데 Trn2 울트라서버는 2024년에 NVL72와 나란히 64칩 랙 규모 확장에 도달했고 일관 크로스바가 아니라 메시지 전달 토러스로 그것을 했다. AWS가 나이트로 카드부터 API까지 모든 층을 소유하고 앵커 테넌트 하나가 프런티어 규모에서 그것을 검증한다. 앤스로픽의 100만 개가 넘는 트레이니엄2 칩이다.
더 생각해보기
- 칩당 FP8이 약 2배 안으로 수렴했다면 앞으로 경쟁의 실질은 실리콘이 아니라 랙 설계와 냉각과 전력 조달로 옮겨 가는가.
- 플롭당 바이트에서 모든 GPU가 굶고 있다는 판정이 맞다면, 왜 시장은 균형 잡힌 웨이퍼가 아니라 굶은 GPU를 선택하는가.
- 컴파일러가 스케줄러인 TPU와 Groq는 맞히면 멈추지 않고 틀리면 대안이 없다. 이 취약함이 실제 운영에서 어떻게 드러나는가.
- Cerebras의 비구조화 희소성이 유일하게 수확 가능한 실리콘인데도 아직 간판 모델이 없다는 사실은 하드웨어 능력과 모델 관행 사이의 어떤 간격을 보여 주는가.
- 결정론을 위해 영 건너뛰기를 거부한 Groq의 선택은 원칙이었는가, 아니면 2세대 칩이 출하되지 못한 결과와 분리할 수 없는가.
- 디코드가 순수한 대역폭 문제라면 프리필과 디코드를 다른 칩에 나누는 분리 방식이 앞으로 표준이 되는가.
- 트레이니엄처럼 앵커 테넌트 하나로 검증되는 모델은 그 테넌트가 이탈할 때 어떻게 되는가.
- 액체 냉각이 1,000와트 이상에서 필수라면 데이터센터 입지 조건이 칩 선택을 역으로 제약하기 시작하는가.
- 프로그래밍 모델을 바꾸지 않고 원시 연산을 얹어 온 NVIDIA의 전략은 어느 지점에서 한계에 도달하는가.