Jev가 다시 꺼낸 빠른 구조화 출력, 모델보다 추론 방식의 차이일까
Jev의 저지연 구조화 결정을 기존 LLM의 단일 토큰 선택과 비교하고, 속도·형식 보장·확률 보정·정답률을 구분한다.
TL;DR
- Jev는 자유로운 문장 대신 미리 정의한 선택지와 자료형에 맞는 결정을 반환한다. 여러 출력을 토큰마다 순차 생성하지 않는 방식이 짧고 일정한 응답 시간의 바탕이다. Sean Goedecke가 주목하는 가치는 대화형 앱 밖의 작은 의사결정에 AI를 넣는 인터페이스다.
- 기존 LLM도 선택 결과 하나만 생성하도록 줄이면 빨라질 수 있다. 저자는 Qwen2.5-1.5B-Instruct의 응답 접두사를 미리 채운 시험에서 일반 구조화 출력보다 2~3배 속도 향상을 얻었다. 이 시험은 Jev와 성능이 같다는 증거가 아니라 비교할 추론 방식을 다시 골라야 한다는 근거다.
- 선택지 밖으로 벗어나지 않는 것과 정답을 고르는 것은 다르다. 하늘색을 묻는 질문에 허용된 선택지인 빨강을 반환하면 형식은 맞아도 판단은 틀린다. 확률값을 내보낸다는 사실과 그 확률이 실제 정확도에 맞게 보정됐다는 주장도 별도로 확인해야 한다.
- 출시 측의 70~500ms 응답 시간에는 측정 환경과 비교 방식의 조건이 붙는다. 긴 숙고를 생략하는 대신 저지연을 얻는 모델을 더 똑똑한 범용 추론의 새 방향으로 단정하기는 어렵다. 같은 입력·선택 문제를 공정하게 비교해야 모델 학습과 출력 방식의 기여를 구분할 수 있다.
문장을 쓰는 대신 프로그램이 쓸 결정을 반환한다
Jev는 자연어를 포함한 상태를 입력받고 호출자가 정한 구조 안에서 답을 고른다. 하늘색을 묻는 상태와 파랑·빨강·노랑이라는 선택지를 주면 자유로운 설명문 대신 그중 하나를 반환하는 식이다. 기존 LLM도 구조화 출력을 만들 수 있으므로 자료형이 정해졌다는 사실만으로 새로운 모델 범주가 되는 것은 아니다. 차이는 결과를 만드는 과정과 그 과정을 전제로 설계한 인터페이스에 있다.
일반적인 구조화 출력은 JSON 문법에 맞지 않는 토큰을 막으면서도 토큰 자체는 하나씩 생성한다. 답의 의미와 무관한 괄호와 키 이름, 구분자도 순차 생성에 포함된다. TypeSafe는 Jev가 여러 결정과 확률을 병렬로 출력하며 자유로운 문자열 생성은 포기했다고 설명한다. Goedecke는 이렇게 짧은 결정을 빠르게 반환하는 기능이 복잡한 챗봇을 만드는 일과 다른 종류의 프로그램을 가능하게 할 수 있다고 본다.
짧은 지연 시간이 바꾸는 사용처
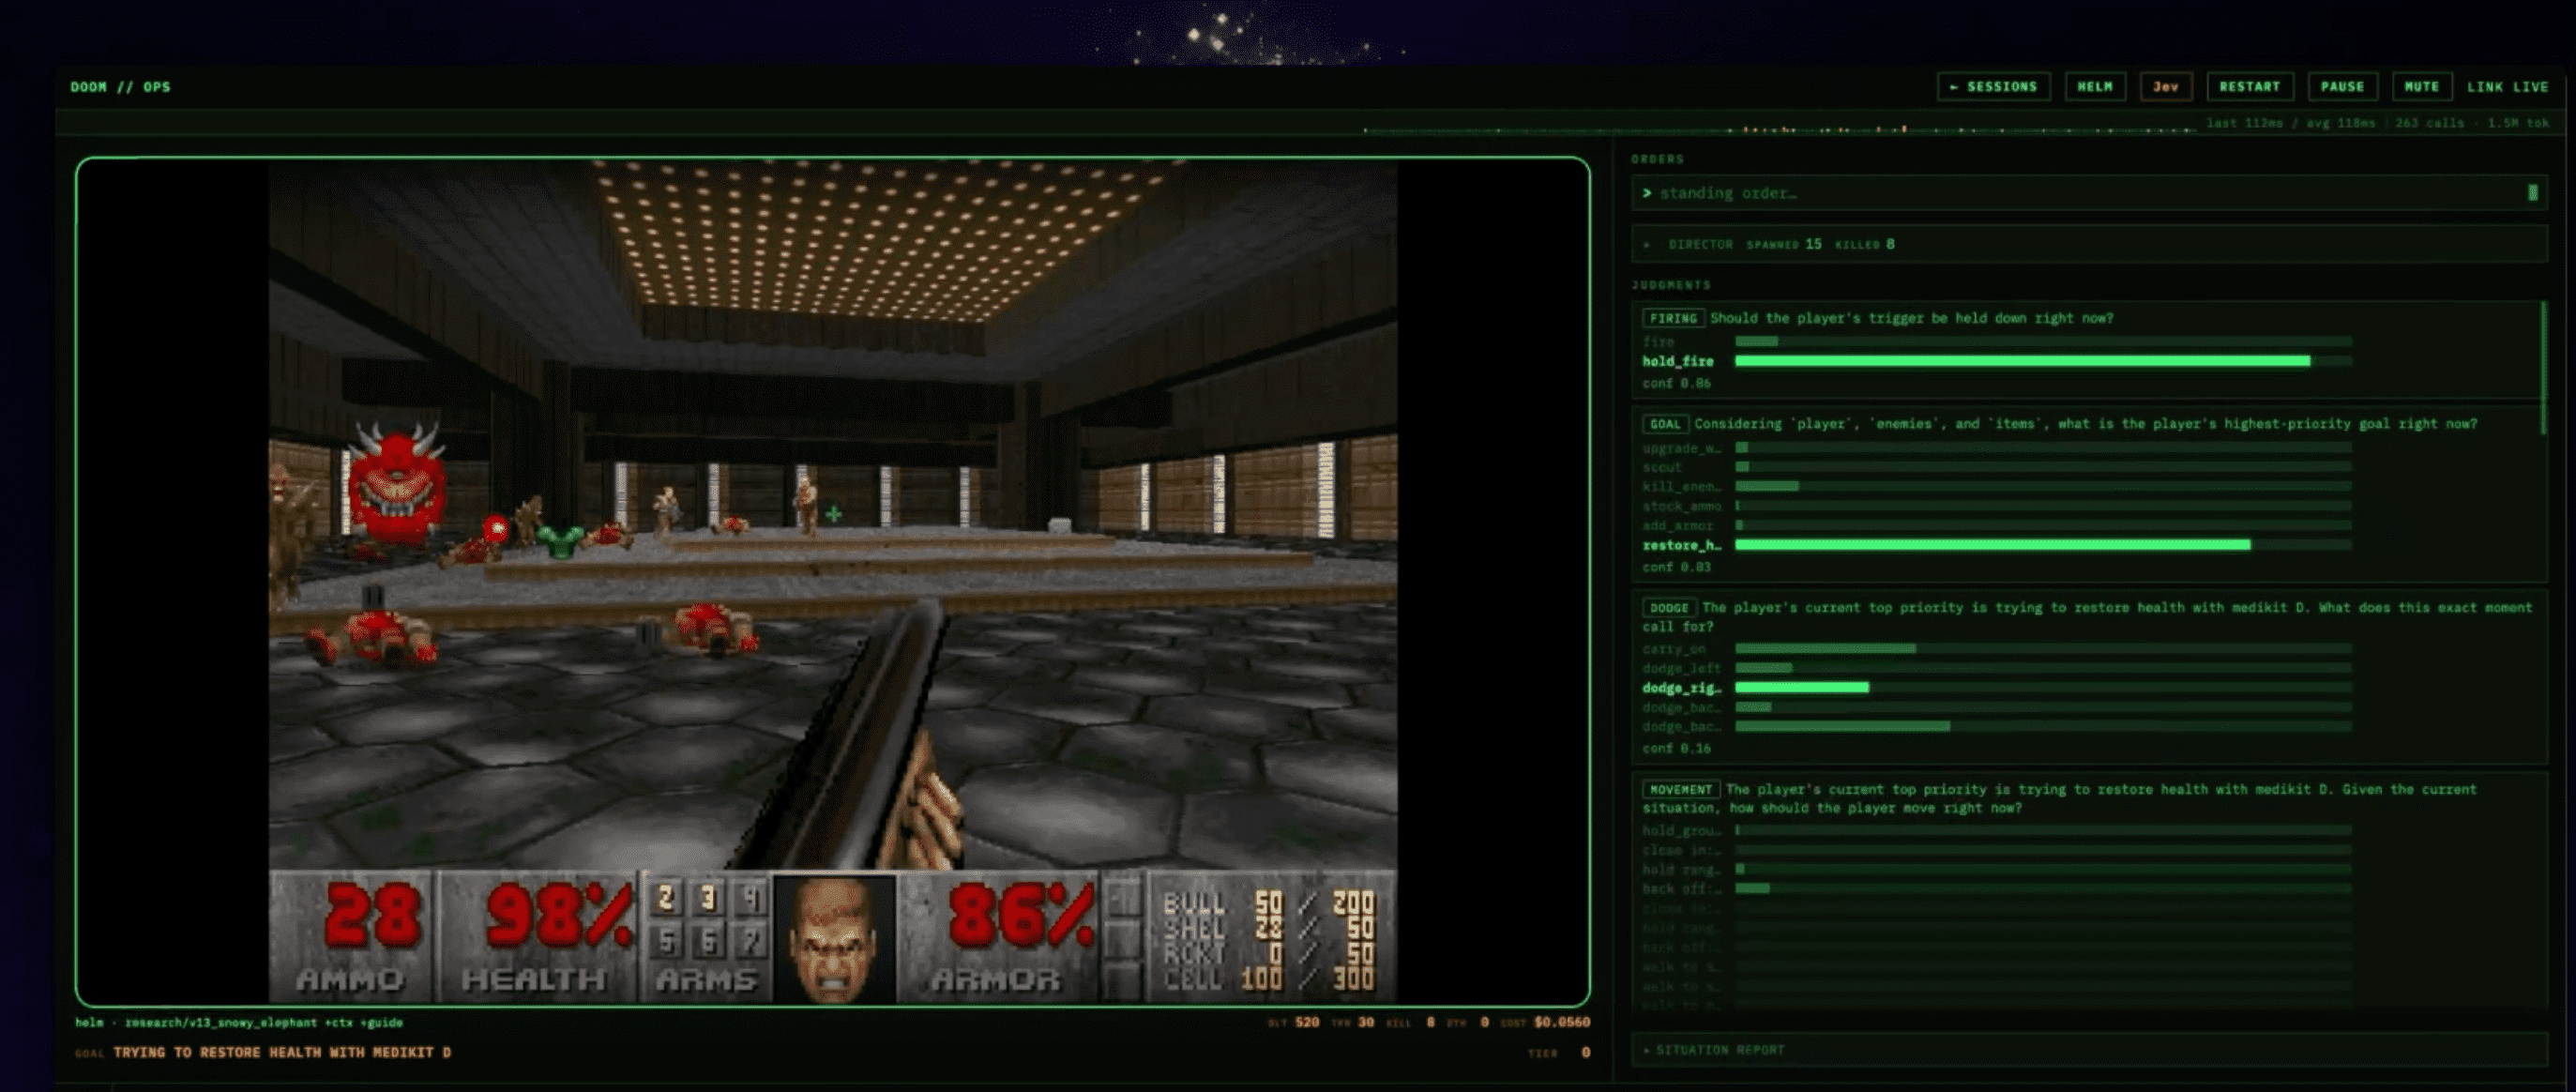
출시 측이 내건 응답 시간은 70~500ms다. Doom 데모에서는 게임 상태를 텍스트 구조로 전달하고 방아쇠를 누를지, 어떤 목표를 추구할지, 어떤 키 입력을 보낼지를 결정한다. 화면 이미지를 보고 플레이하는 데모는 아니다. 특정 게임만을 위해 학습한 전용 봇과 달리 같은 모델 인터페이스를 다른 결정 문제에도 쓰려는 시도라는 점이 저자의 관심사다.
다만 이 지연 시간 범위를 모든 지역과 부하에서 보장되는 서비스 수치로 받아들이면 안 된다. TypeSafe는 공개 평가를 대체로 서비스가 위치한 미국 서부의 노트북에서 실행했다고 밝힌다. 나란히 비교한 데모의 짧고 밀도 높은 입력도 Jev에 유리한 조건이었다고 인정한다. 긴 입력을 읽는 시간과 네트워크 조건까지 사라지는 것은 아니므로 짧은 출력의 이득과 요청 전체의 응답 시간은 구분해야 한다.
기존 LLM도 답 하나만 생성하게 한다면
Goedecke의 반론은 기존 LLM에 매번 JSON 전체를 쓰게 할 필요가 없다는 데서 출발한다. 응답에서 답 직전까지의 접두사를 미리 채우고 허용된 선택지에 해당하는 토큰 하나만 생성하게 하면 출력 단계가 짧아진다. 여러 질문은 일반적인 추론 배치로 묶을 수 있다. 긴 구조화 문서를 생성하는 기능을 포기하는 대신 제한된 선택 문제에 맞춰 속도와 처리 방식을 조정하는 접근이다.
선택지의 글자 수와 토큰 수가 다르다는 문제는 남는다. 여러 토큰으로 나뉘는 선택지를 한 토큰 식별자로 대응시키거나 구분 가능한 첫 토큰만 생성하는 등의 방법이 필요할 수 있다. 이 부분은 저자가 직접 시험하지 않았다고 밝힌 아이디어다. 따라서 임의의 선택지 목록을 넣기만 하면 한 토큰 추론으로 바뀐다는 완성된 구현 설명으로 읽어서는 안 된다.
저자가 실제로 시험한 모델은 Qwen2.5-1.5B-Instruct이며 접두사를 채우지 않은 구조화 출력보다 2~3배 빨랐다는 결과를 각주에 남겼다. 하드웨어와 입력 길이, 정확도를 함께 비교한 상세 벤치마크는 본문에 없다. 작은 모델에서 관찰한 속도 향상만으로 Jev와 지능이나 지연 시간이 동등하다고 결론 내릴 수는 없다. 그럼에도 JSON을 토큰마다 생성하는 LLM만 비교 대상으로 삼으면 Jev의 모델 자체와 출력 방식이 각각 얼마나 기여했는지 분리하기 어렵다는 문제는 남는다.
형식 보장과 확률의 신뢰도는 별개다
Jev가 허용된 선택지만 출력한다면 존재하지 않는 값이나 잘못된 자료형을 생성하는 문제는 막을 수 있다. 그러나 하늘색을 빨강으로 선택하는 판단 오류까지 없어지지는 않는다. Goedecke가 환각이 없다는 홍보 문구를 비판하는 이유다. TypeSafe도 출시 글의 세부 설명에서는 도표에 넣은 오류율 0%가 실측 정답률이 아니라 스키마 일치 보장에 근거한다고 밝힌다.
확률 보정에도 같은 구분이 필요하다. TypeSafe는 RLCD, 즉 Reinforcement Learning for Calibrated Decisions라는 학습 방식과 보정된 확률을 강조한다. Goedecke는 보통의 로짓 확률과 무엇이 다른지, 불확실한 상황에서 어떤 학습으로 정확도를 맞추는지 공개 설명만으로는 판단하기 어렵다고 본다. 공개 근거가 더 필요하다는 비판이며 보정 학습이 없다고 입증한 결과는 아니다.
출시 측 워크플로 평가는 독립적으로 확인한 정답 대신 GPT-6 Astra와 Fable 5.1의 평균 예측을 기준으로 비교한다. 같은 워크플로를 사용하더라도 이 기준에는 참조 모델의 성향이 들어간다. TypeSafe는 비교용 LLM에 호환되는 구조화 결정과 확률을 출력시키는 래퍼를 사용했고 확률 없이 결정만 받는 것보다 느리고 비싸지는 경향도 인정했다. 보정된 확률이 필요한 실제 업무라면 그 기능을 함께 비교해야 하지만 단순 분류 속도와 혼동해서는 안 된다.
저지연의 가치와 추론 능력의 한계를 나누어 본다
Goedecke는 일정하고 짧은 응답 시간을 지키려면 테스트 시점의 긴 숙고를 활용하기 어렵다고 본다. 이 때문에 이런 모델의 능력이 비추론형 LLM 수준 부근에서 제한될 가능성을 제기한다. 저자의 전망에 해당하며 향후 성능을 입증한 한계 정리는 아니다. 반복 계산을 늘리는 설계는 가능하더라도 응답 시간을 늘리거나 예측하기 어렵게 만들면 원래 목표와 충돌할 수 있다.
그럼에도 저자는 Jev의 등장을 반긴다. 구조화 출력만을 위해 학습하고 최적화한 모델에는 기존 모델을 개조하는 것보다 유리한 점이 있을 수 있다. 기술적 우위가 얼마나 오래 유지될지는 불확실하지만 저렴하고 빠른 결정 기능에 경쟁이 붙는 일 자체가 유용하다. 모델의 독창성이나 범용 지능 향상과 별개로 소프트웨어가 필요한 순간에 작은 판단을 호출하는 사용법을 넓혔다는 평가다.
참고 자료
Sean Goedecke — Jev means structured output is interesting again