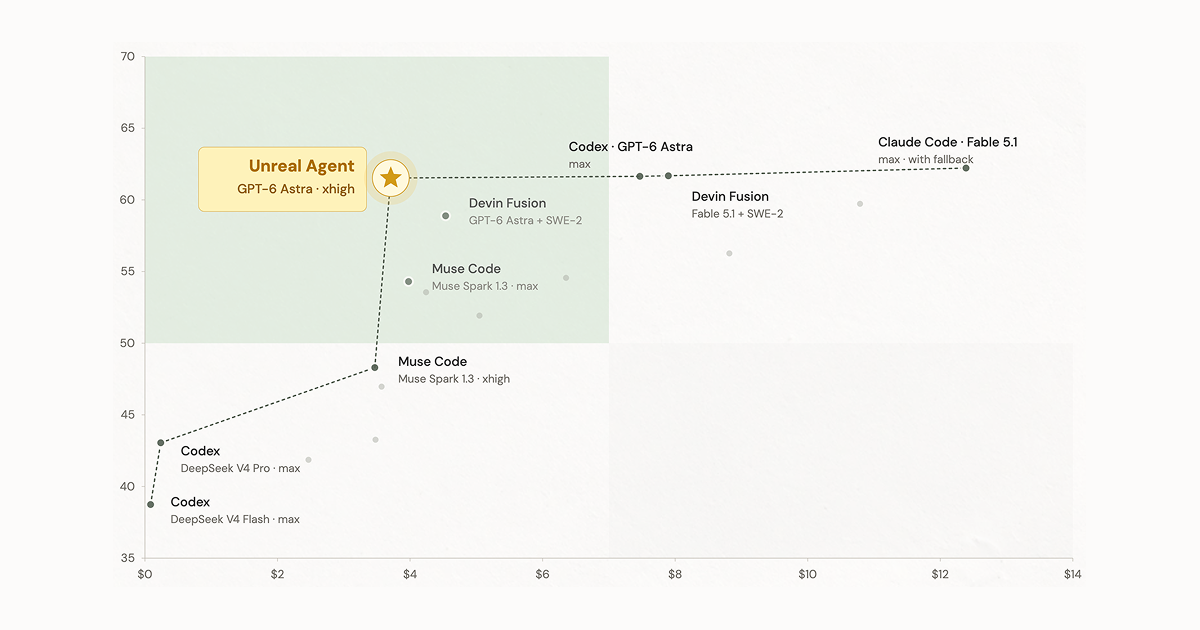
Unreal Agent의 비용 절감, 도구를 기다리는 일을 모델 밖으로 옮긴다
Unreal Agent의 비동기 도구 실행과 이벤트 로그 설계가 모델 턴과 입력 토큰을 줄이는 방식, 공개 벤치마크의 비용 비교와 제공자 호환성 조건을 살펴본다.
TL;DR
- Unreal Agent는 도구 실행을 비동기로 관리해 모델이 대기와 폴링을 반복할 필요를 줄인다. 도구를 시작하면 진행 중 상태를 기록하고 실제 결과는 완료 시 세션 로그에 추가한다. 기다리는 동안 다른 일을 진행하고 사용자의 방향 수정도 받을 수 있도록 설계했다.
- 공개 평가는 GPT-6 Astra의 xhigh 설정으로 Codex와 Pi를 비교했다. Terminal-Bench 4.0에서 Unreal과 Codex 리더보드 기준선의 성공률은 모두 57.9%였고 총비용은 각각 1,428달러와 2,350달러였다. 비용 차이는 약 39.2%지만 다른 평가에서도 같은 절감률이 나온 것은 아니다.
- 모델 턴 감소와 도구 호출 수 감소는 같은 목표가 아니다. SWE-Atlas에서는 Unreal이 Codex보다 도구를 더 호출하면서도 모델 턴과 입력 토큰을 줄였다. 대기 관리와 도구 결과가 만드는 문맥 비용을 줄이는 것이 이 설계의 초점이다.
- 진행 중 결과와 최종 결과를 같은 문맥에 넣는 방식은 제공자 호환성을 확인해야 한다. 보안도 하네스의 판단만 믿기보다 환경 격리와 세밀한 권한으로 강제하는 방향을 제안한다. 비용 절감과 작은 성공률 차이를 통계적 동등성이나 모든 운영 환경의 보장으로 받아들여서는 안 된다.
도구 실행의 생명주기를 누가 관리할 것인가
Unreal Labs는 실제 에이전트 제품을 운영하면서 모델이 도구의 대기와 상태 확인에 많은 시간과 토큰을 쓴다는 문제를 발견했다. 개발 환경 준비에는 몇 분이 걸리지만 그동안 코드베이스를 읽거나 웹에서 정보를 찾는 일은 진행할 수 있다. 이런 작업을 모델이 반복해서 기다리고 확인하도록 맡기면 유용한 판단 외에 실행 관리 비용이 붙는다. Unreal Agent는 그 관리를 하네스가 맡도록 설계했다.
도구 호출이 나오면 실제 작업을 백그라운드에서 실행하면서 세션 로그에 진행 중 상태의 결과를 즉시 추가한다. 작업이 끝났을 때 최종 결과를 로그에 붙이고 모델을 다시 호출한다. 진행 중이라는 기록을 성공 결과로 취급하는 방식은 아니다. 사용자도 도구 종료를 기다리지 않고 방향을 바꿀 수 있게 하며 모델 호출 사이에 더 많은 도구 작업을 진행하려는 구조다.
이벤트 기록과 실행을 분리한 구조
공개 README는 도구 호출과 실제 작업을 서로 다른 단위로 나눈다. 도구 번역기는 모델이 요청한 호출을 검증해 하나 이상의 직렬화 가능한 operation으로 바꾸고 실행 관리자는 이를 비동기로 수행한다. 번역기는 조정자의 이벤트 루프에서 동기적으로 실행되므로 입출력을 수행하거나 루프를 멈춰서는 안 된다는 규칙이 있다. 느린 작업이 요청 처리 자체를 막지 않도록 책임을 분리했다.
세션 저장소는 추가 전용 이력과 작업 상태를 보존하고 복구와 분기를 지원한다. 문맥 구성기는 모델 입력을 만들면서 생략·절단·압축한 항목도 기록하지만 직접 입출력이나 영속 저장을 맡지 않는다. 외부 입력의 중복 방지용 inbox는 세션 범위의 메모리 상태라고 설명돼 있어 이를 모든 장애 상황의 영구 중복 방지 보장으로 확대할 수는 없다. 이런 구성 요소의 경계를 통해 재시작과 취소, 백그라운드 작업을 모델 프롬프트 밖의 실행 문제로 다룬다.
적은 모델 턴으로 더 많은 도구 작업을 한다
Unreal Labs는 비용 절감의 원인으로 작은 프롬프트와 토큰을 아낀 도구 결과, 한 번의 모델 턴에서 더 많이 진행하는 비동기 작업을 꼽는다. 소개된 하네스는 하위 에이전트나 별도 워크플로를 두지 않는 단순한 구성을 택했다. 도구를 기다리거나 폴링하는 데 모델을 다시 부르는 부담을 줄이는 방향이다. 다만 공개 비교는 이 요소들을 각각 제거한 실험이 아니므로 절감액을 비동기 실행 하나의 효과로 확정하지는 못한다.
SWE-Atlas Codebase QnA 수치가 그 차이를 드러낸다. Unreal은 모델 턴 16회와 도구 호출 27회, Codex는 모델 턴 22회와 도구 호출 21회로 보고됐다. 시도당 입력은 각각 898k와 1.69M 토큰이다. 도구 호출은 더 많아도 모델이 문맥을 다시 읽고 다음 행동을 정하는 횟수와 입력량은 줄어든 셈이다. 모든 도구 호출을 줄이는 최적화와는 다른 접근이다.
네 가지 평가에서 비용과 성능을 읽는 법
공개 비교는 GPT-6 Astra의 xhigh 추론 설정을 사용한다. Terminal-Bench 4.0에서 Unreal과 Codex 리더보드 기준선의 성공률은 57.9%로 같고 총비용은 1,428달러와 2,350달러다. 원문 표의 금액으로 계산하면 약 39.2% 절감으로, 최대 40%라는 소개 문구에 가까운 사례다. Pi는 성공률 55.0%와 비용 1,827달러였으며 같은 방식의 비용 차이는 약 21.8%다. 이 평가의 Codex 값은 별도 리더보드 기준선이라는 조건도 남겨야 한다.
SWE-Atlas에서는 Unreal이 성공률 65.8%와 비용 936달러, Codex가 63.3%와 1,303달러, Pi가 64.0%와 1,033달러였다. DeepSWE 1.1에서는 각각 72.4%·1,367달러, 69.0%·1,633달러, 69.6%·1,584달러로 보고됐다. Codex 대비 비용 차이를 표에서 계산하면 각각 약 28.2%와 16.3%다. 같은 모델을 쓰더라도 과제에 따라 하네스의 비용 차이는 달라지며 어느 한 최대치를 전체 작업에 적용할 수는 없다.
Agents’ Last Exam의 ALE-CLI에서는 완전 통과율과 평균 점수가 별도 지표다. Unreal은 완전 통과율 30.0%·평균 점수 59.7·비용 217달러, Codex는 29.0%·58.1·292달러, Pi는 29.0%·59.2·262달러다. 여기서 Codex 대비 비용 차이는 약 25.7%다. 저자들은 작은 성공률 차이를 평가 변동으로 설명하지만 신뢰구간이나 동등성 검정은 본문에 제시하지 않았다. 좋은 점수와 낮은 비용이 보고됐다는 사실과 성능 저하가 없음을 통계적으로 보장하는 주장은 구분된다.
Terminal-Bench의 공개 Harbor 실행도 확인할 수 있다. 해당 화면은 330개 시도가 종료됐고 그중 329개가 완료, 하나가 오류였다고 표시하지만 시도별 추론 비용은 제공하지 않는다. 따라서 링크가 공개됐다는 사실만으로 본문 가격표까지 독립 재현했다고 볼 수는 없다. ALE-CLI 실행은 Harbor에 없다고 원문이 밝히며 이 노트에서도 벤치마크를 다시 실행하지 않았다. 입력 토큰 수만으로 캐시와 요금 조건을 포함한 실제 청구액을 복원할 수 없다는 점도 비용 비교의 확인 항목이다.
제공자 호환성과 안전장치를 남겨 둔다
이벤트 로그의 진행 중 결과와 최종 결과를 모델 문맥으로 바꾸는 방식에는 호환성 문제가 있다. 원문 각주는 하나의 문맥에 두 도구 결과 항목을 넣는 사용법이 Responses API 문서에서 충분히 규정돼 있지 않으며 일부 OpenAI 외 제공자의 모델이 이를 거부했다고 설명한다. function_call_output의 status 필드도 해당 경우에는 도움이 되지 않았다. 문맥 형식을 수용한 모델은 진행 상태에서 완료 상태로의 변화를 이해했지만 모든 제공자에게 같은 입력이 통한다는 뜻은 아니다.
보안과 승인은 별도의 경계가 필요하다. Unreal Labs는 하네스 훅과 특수 도구에 기대는 방식보다 허용 호스트와 제한된 접근 토큰, 승인 게이트가 있는 프록시 등 하네스 밖에서 강제하는 제약을 선호한다고 설명한다. SDK는 Go 라이브러리와 실행기, Harbor 호환 벤치마크 실행기를 제공하지만 이를 붙이는 것만으로 격리 정책이 완성되지는 않는다. 모델이 기다림을 관리하는 부담을 덜어내면서 실제 실행의 권한과 중단 조건을 시스템에 남기는 것이 이 설계에서 함께 읽을 부분이다.